El calendario de contenidos de tu equipo está lleno, el próximo briefing está pendiente y alguien acaba de soltar "palabras clave LSI" en el hilo de Slack como si fuera un atajo para mejorar el posicionamiento. El problema es que muchos optimizadores de contenido persiguen la frase sin entender el método que hay detrás, por lo que terminan añadiendo sinónimos forzados, repitiendo términos de forma antinatural y llamándolo optimización. La Indexación Semántica Latente (LSI, por sus siglas en inglés) es más antigua, más técnica y mucho más interesante que eso.
¿Qué es la indexación semántica latente? es una pregunta sobre cómo las máquinas pueden entender el significado a partir de patrones en el lenguaje, no solo mediante coincidencias exactas de palabras. Esa distinción es importante porque separa la teoría real de recuperación de información del mito de marketing de que el LSI es una táctica de relleno de palabras clave. Si alguna vez has tenido que explicar a los redactores por qué "simplemente añadir más palabras relacionadas" no es una estrategia, esta guía es para ti.
Introducción a la Indexación Semántica
Un equipo de contenido suele notar el mismo patrón. Una página se posiciona mal, alguien revisa las páginas de la competencia y el equipo decide que la respuesta debe ser "más palabras clave LSI". El borrador resultante viene cargado de frases vagamente relacionadas, pero el texto suena extraño y la página sigue sin resolver el problema del lector.
Esa frustración suele comenzar con un malentendido. La Indexación Semántica Latente se introdujo como una forma de reducir el desajuste léxico en la recuperación de información, utilizando índices de conceptos derivados estadísticamente en lugar de coincidencias de palabras individuales, y lo hace a través de la SVD truncada en una matriz término-documento artículo sobre LSI. En términos académicos, se trata de descubrir patrones ocultos en todo un corpus, no de espolvorear sinónimos en una entrada de blog.
Para los profesionales del marketing, esa distinción es la clave. El valor del LSI no reside en un truco mágico de posicionamiento, sino en la idea de que el significado puede inferirse a partir del contexto, la coocurrencia y la estructura temática. Ese es el cambio de mentalidad que los equipos necesitan antes de poder hacer un buen SEO semántico.
Entendiendo la Indexación Semántica Latente
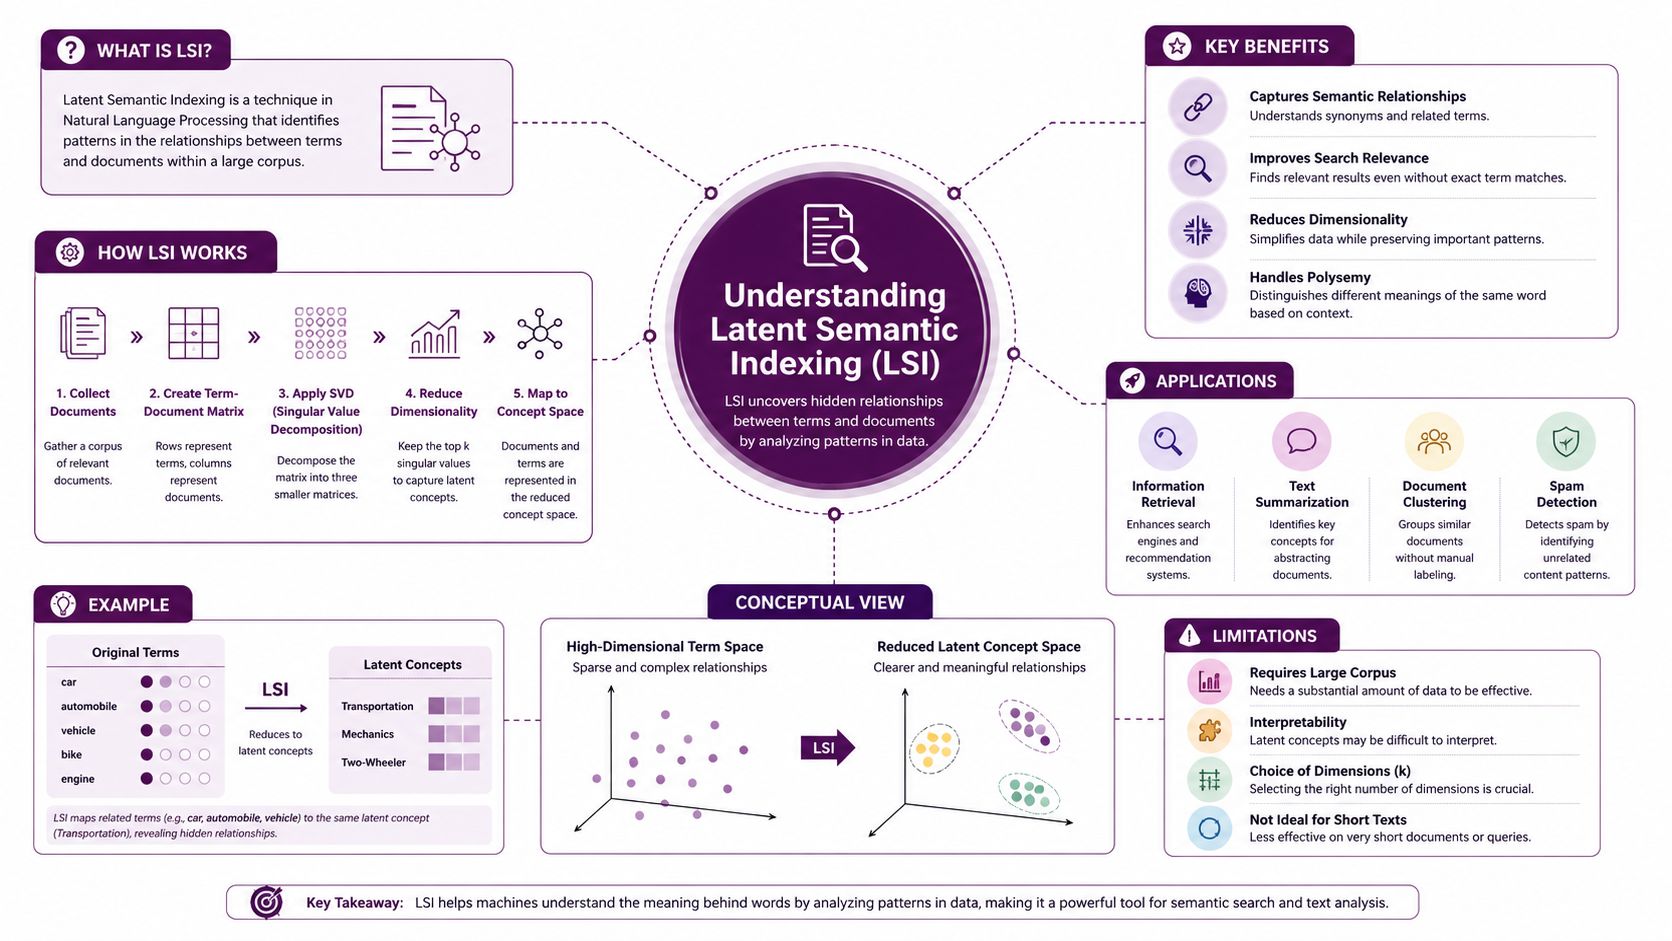
Cómo funciona el método
Imagina una matriz término-documento como una hoja de cálculo gigante. Las filas son palabras, las columnas son documentos y los números muestran dónde aparecen los términos juntos. El LSI aplica la descomposición en valores singulares (SVD) a esa matriz y la comprime en un espacio semántico de menor dimensión, típicamente alrededor de 100–300 factores latentes ortogonales TREC.
Esa reducción es importante porque no solo comprime los datos, sino que expone su estructura. Una consulta y un documento pueden situarse cerca en el espacio latente incluso cuando no comparten las mismas palabras superficiales, por lo que el LSI ayuda con la sinonimia y el desajuste de vocabulario. El libro de texto de RI de Stanford describe esto como una aproximación de bajo rango de la matriz término-documento, que mantiene una alta similitud incluso cuando la superposición exacta de términos es baja libro de RI de Stanford.
Regla práctica: si dos páginas usan una redacción diferente pero responden a la misma intención, la similitud semántica puede hacer que estén relacionadas.
Por qué es importante para la relevancia
La forma más sencilla de entender el LSI es compararlo con una linterna en una habitación oscura. La coincidencia de términos en bruto solo ilumina las palabras que puedes ver directamente. El LSI intenta revelar la forma de la habitación en sí, las relaciones ocultas que conectan esas palabras a través de muchos documentos.
Es por eso que el método se volvió influyente en la investigación de recuperación de información. Una consulta sobre un término puede coincidir con un documento que usa otro término, siempre que ambos participen en patrones de coocurrencia similares en todo el corpus artículo de MSU. Si buscas una taxonomía práctica para agrupar esas relaciones temáticas en la planificación de contenidos moderna, un complemento útil es este glosario de clusters temáticos.
La confusión principal para muchos equipos es pensar que el método trata sobre las palabras clave en sí. No es así. Se trata de la geometría estadística del lenguaje, y es por eso que se convirtió en una idea fundamental en los sistemas de recuperación mucho antes de que la gente de SEO empezara a hablar de ello.
Historia y relación con el LSA
De dónde viene el LSI
El LSI entró en el campo a través de un artículo de 1990 de Deerwester y sus colegas, donde el objetivo era reemplazar la coincidencia de palabras individuales por índices de conceptos utilizando SVD truncada artículo sobre LSI. Ese origen es importante porque demuestra que el método fue diseñado para problemas de recuperación y agrupación, no para textos de marketing.
El marco académico también hace que la confusión de nombres sea más fácil de entender. En la práctica, a veces se confunden LSI y LSA, pero las fuentes en este resumen describen el mismo linaje desde una perspectiva de recuperación de información, centrado en la aproximación de matrices, la coocurrencia oculta y la estructura conceptual. El material de Stanford enfatiza la visión de matriz de bajo rango, mientras que otras notas de clase enmarcan el mismo enfoque como una técnica de reducción de rango basada en el teorema de Eckart-Young artículo de lingüística de Stanford.
Por qué la historia sigue siendo importante hoy
Este contexto es importante porque evita un error común en SEO. Cuando alguien dice "palabras clave LSI", generalmente está usando una etiqueta de marketing vaga, no el método académico original. Las fuentes académicas fundamentales describen el LSI como una técnica clásica de recuperación basada en SVD, no como una táctica de relleno de palabras clave libro de RI de Stanford.
Esa diferencia es más que una sutileza académica. Ayuda a los equipos a dejar de tratar la profundidad semántica como una lista de verificación de sinónimos y a empezar a pensar como arquitectos de información. Si necesitas una visión general práctica de cómo este malentendido aparece en los flujos de trabajo de SEO, esta guía de LSI para gestores SEO es un punto de referencia útil.
La forma más clara de recordar la historia es esta: el LSI comenzó como una solución matemática al ruido en la recuperación de información, no como un truco de marketing de contenidos. Una vez que esto queda claro, el resto de la conversación sobre SEO es mucho más fácil de evaluar.
Desmintiendo los mitos de las palabras clave LSI
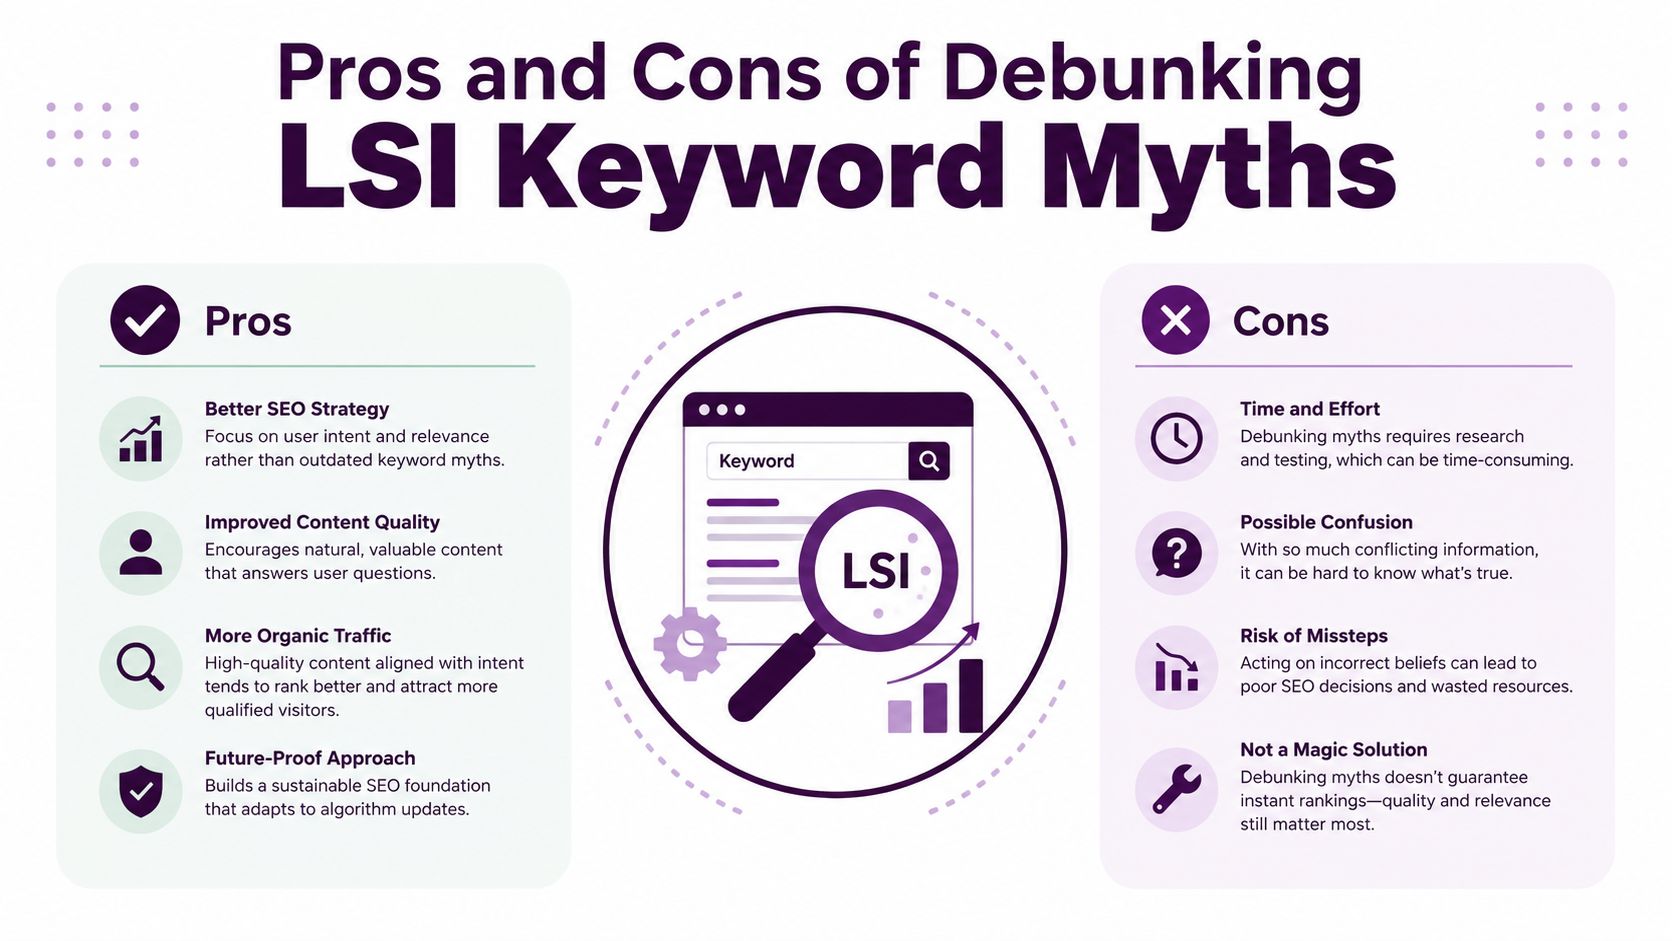
Los mitos que los equipos siguen repitiendo
El primer mito es que las palabras clave LSI son una lista formal de frases que puedes extraer e insertar para mejorar el posicionamiento. Ese planteamiento reduce el método académico a un truco de contenido, que es exactamente contra lo que advierte el libro de RI de Stanford al tratar el LSI como una aproximación de matriz de bajo rango para la recuperación, no como una fórmula de palabras clave libro de RI de Stanford.
El segundo mito es que añadir más términos relacionados hace que una página sea automáticamente más fuerte. En realidad, las listas de sinónimos forzadas a menudo debilitan la claridad, que es lo contrario de lo que pretende lograr la recuperación semántica. El LSI trata de capturar relaciones en un corpus, no de hacer que cada párrafo suene artificialmente amplio.
El tercer mito es que la frase en sí todavía describe un mecanismo de posicionamiento SEO en vivo. Es por eso que muchos artículos lo llaman una táctica moderna cuando las fuentes académicas principales lo enmarcan como un método clásico de RI construido sobre SVD libro de RI de Stanford. Si quieres comparar esta idea errónea con un lenguaje SEO más amplio, la discusión sobre posicionar contenido en respuestas de IA de MyMentions muestra por qué la cobertura semántica importa más que las etiquetas de palabras clave obsoletas.
Qué dejar de hacer
- Deja de crear listas de sinónimos. Si la redacción no ayuda al lector a entender el tema, es relleno.
- Deja de tratar la densidad como un indicador de profundidad. La relevancia semántica proviene de la cobertura, la estructura y la alineación con la intención.
- Deja de asumir que "términos relacionados" significa variaciones aleatorias. Una buena escritura semántica utiliza entidades y conceptos que son integrales al tema.
Una página puede mencionar más términos y aun así parecer menos útil si el texto pierde el enfoque.
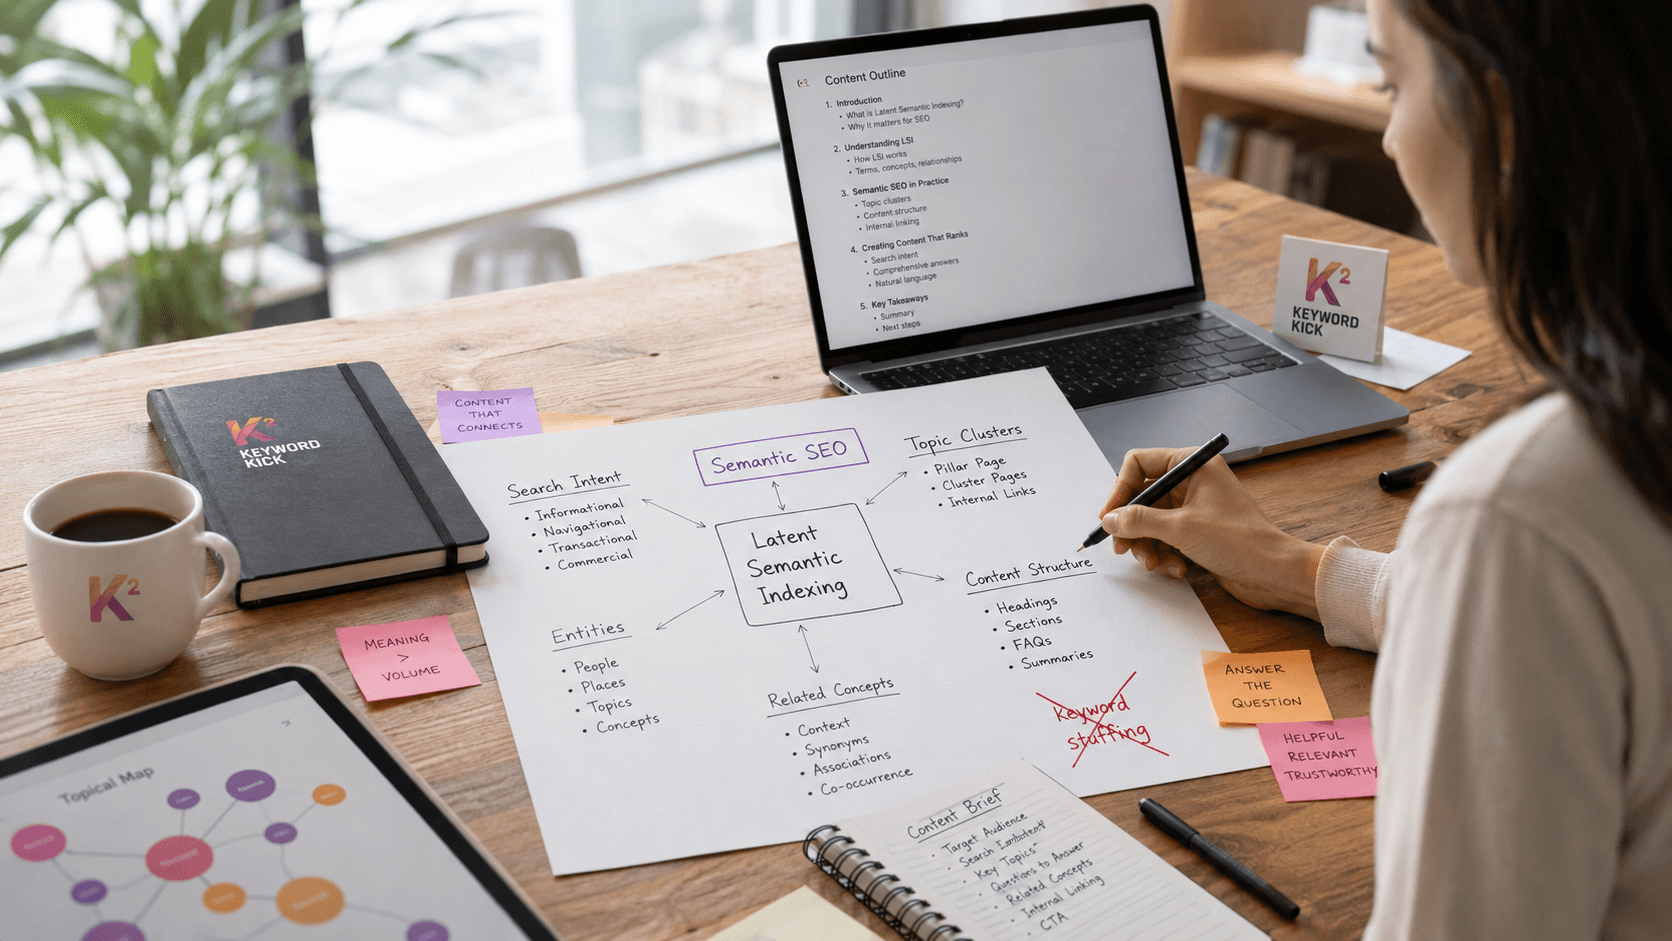
Un modelo mejor es usar el LSI como una lente, no como una lista de verificación. La lente te dice que el significado es contextual, pero no justifica un texto descuidado. El SEO semántico funciona cuando la página responde a la consulta con claridad y luego refuerza esa respuesta con conceptos de apoyo que encajan de forma natural.
Cómo interpretan la semántica los motores de búsqueda
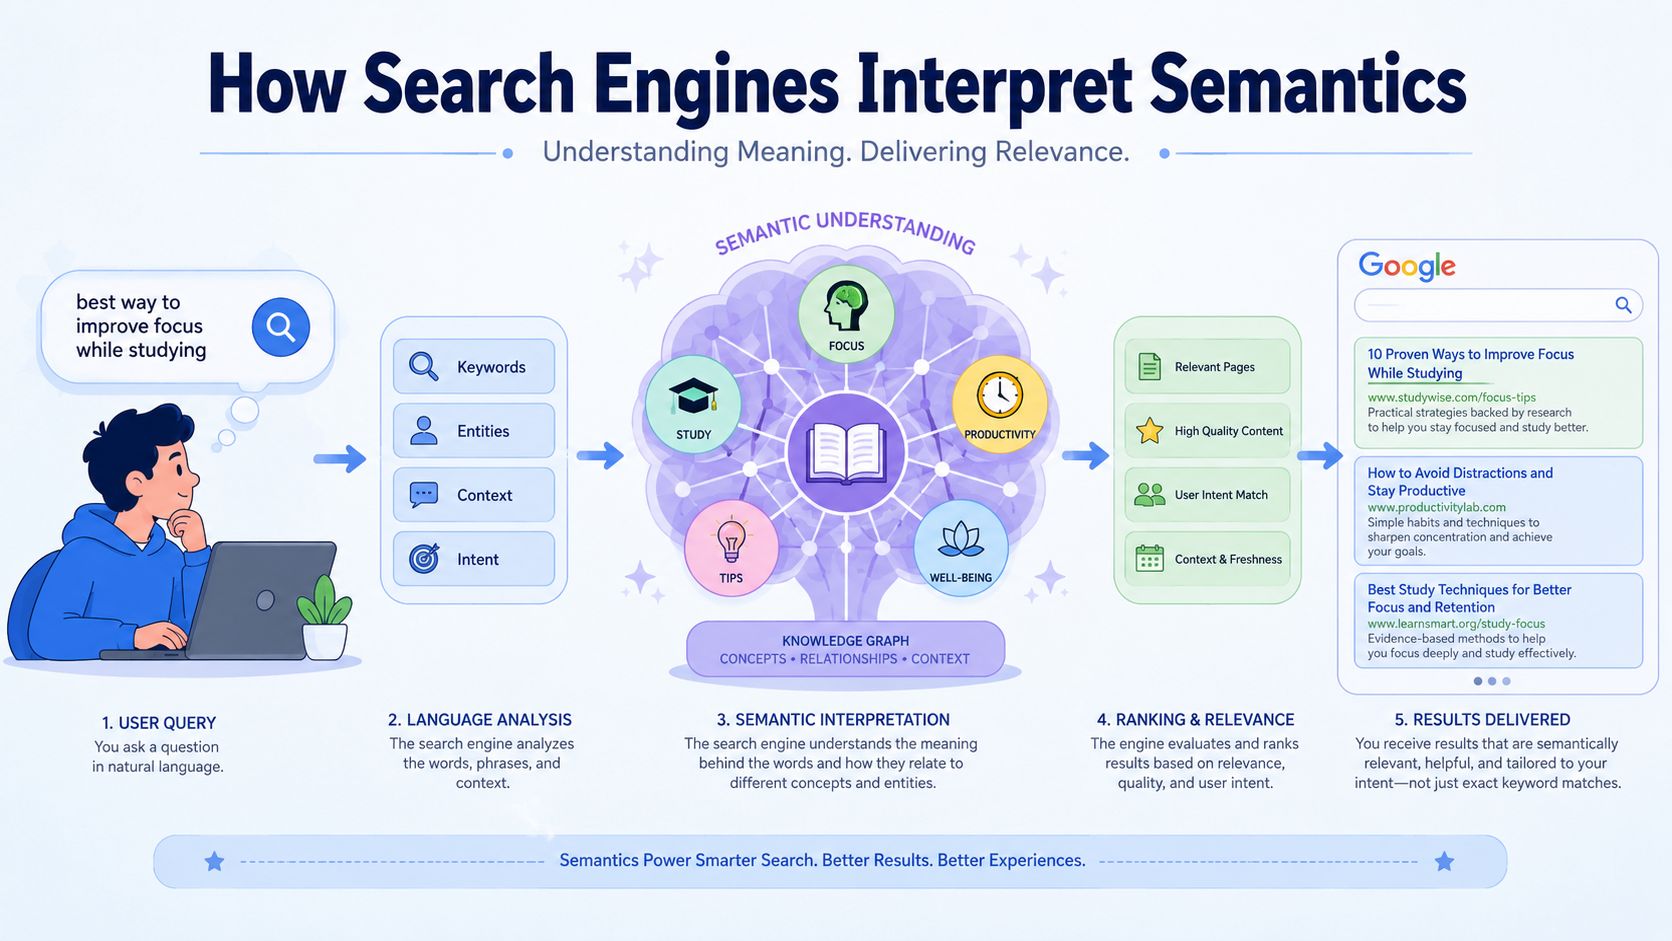
De matrices a significado
Los motores de búsqueda modernos no dependen del algoritmo LSI original, pero persiguen el mismo objetivo general: entender el significado más allá de la superposición exacta de palabras. El modelo LSI histórico utilizaba SVD en una matriz término-documento para inferir la estructura latente TREC. Los sistemas de búsqueda actuales utilizan métodos semánticos mucho más avanzados, pero el principio es familiar: el contexto importa.
Ese cambio es la razón por la que una consulta puede interpretarse correctamente incluso cuando la página no la repite palabra por palabra. Los motores ahora utilizan señales de contexto, reconocimiento de entidades y representaciones basadas en vectores para decidir si un resultado coincide con la intención del usuario. El antiguo enfoque de factorización de matrices es un modelo mental útil, pero no es la capa de posicionamiento en vivo.
Por qué el contexto supera a la coincidencia exacta
Los profesionales del marketing a menudo se exceden. Escuchan que los motores de búsqueda "entienden la semántica" y asumen que cada página necesita un montón de palabras relacionadas. Lo que ayuda es escribir de forma que establezca claramente el tema, el subtema y la intención, para que el motor pueda colocar la página en el vecindario conceptual correcto.
Es también por eso que el enlazado interno y la organización temática importan tanto. Si una página refuerza constantemente un concepto a través de encabezados, cuerpo del texto y páginas relacionadas, proporciona a los sistemas de búsqueda pruebas más sólidas sobre el propósito de la página. Para una visión práctica de cómo los sistemas modernos interpretan y reutilizan las señales temáticas, la entrada del glosario de RankBrain es un puente útil entre las ideas clásicas de RI y el comportamiento de posicionamiento moderno.
Cómo pensar en la búsqueda en la era de la IA
La búsqueda es ahora más conversacional y sensible al contexto que los sistemas que hicieron famoso al LSI. Eso no hace que el LSI sea obsoleto como concepto, lo hace históricamente importante. Dio a los profesionales del marketing una de las primeras explicaciones claras de por qué el pensamiento basado en coincidencias exactas falla cuando el lenguaje es complejo.
Si estás optimizando para respuestas de IA o experiencias de búsqueda enriquecidas, la mentalidad sigue siendo la misma. Cubre el tema con precisión, utiliza términos que pertenezcan al mismo campo conceptual y evita forzar palabras solo porque suenan adyacentes. Para una mirada más profunda a ese cambio en entornos SERP prácticos, consulta posicionar contenido en respuestas de IA de MyMentions.
Optimización de contenido con técnicas semánticas
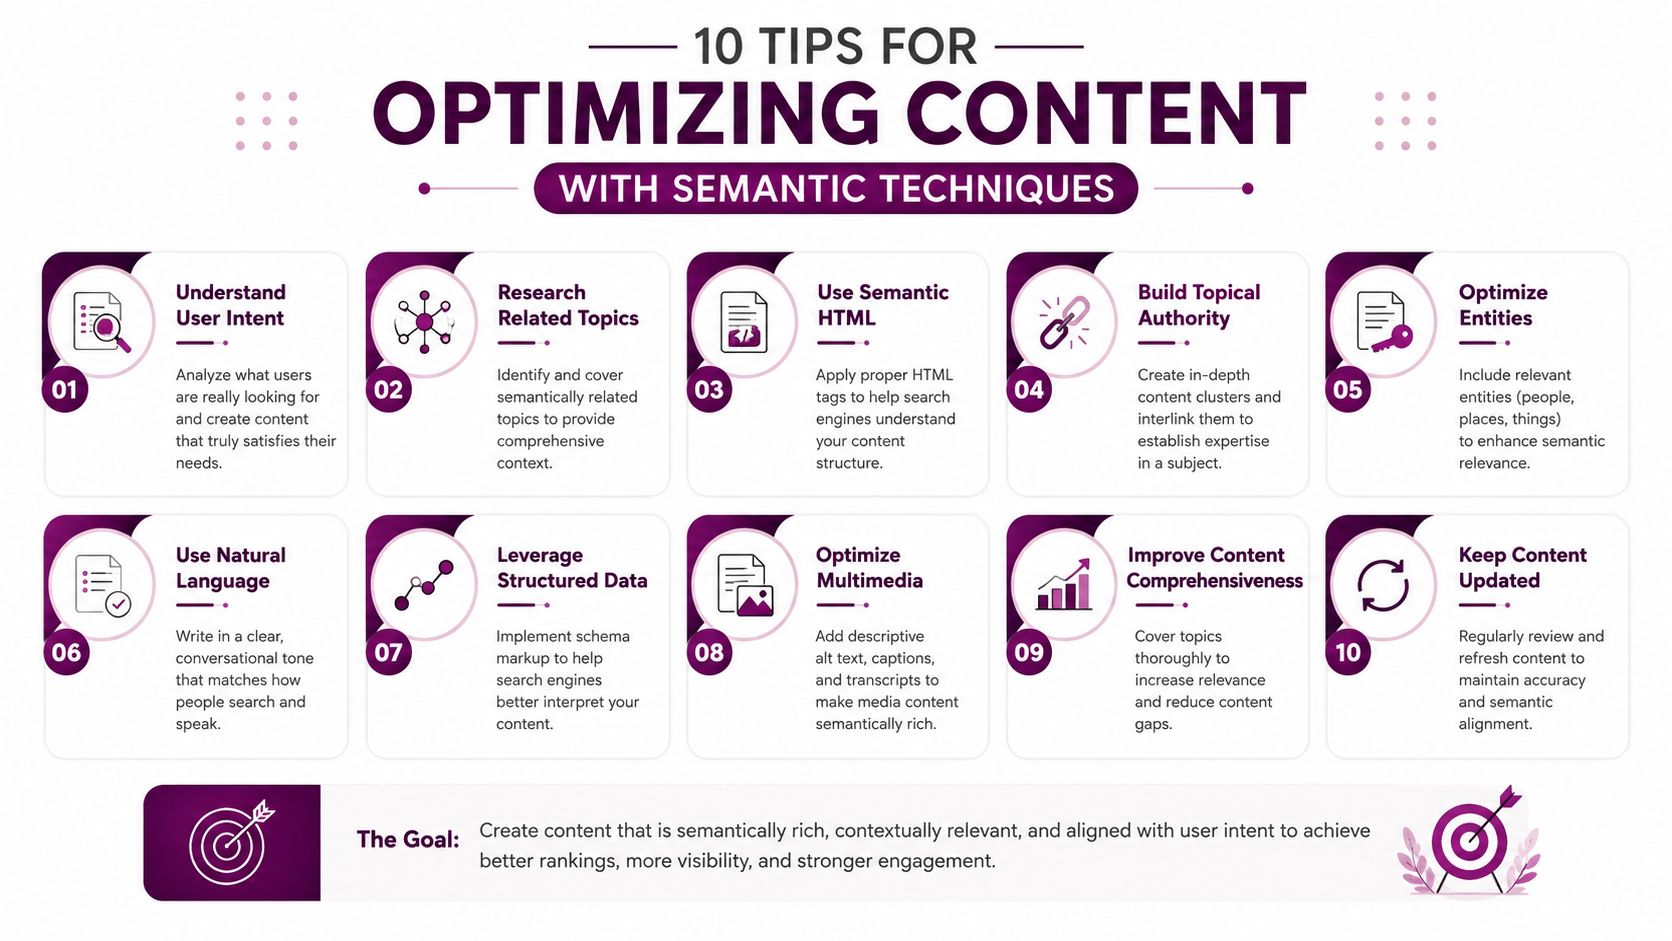
Construye en torno a la estructura temática
Comienza con una página que responda a una intención principal y luego mapea las entidades relacionadas que pertenecen naturalmente a ella. Una página de producto sobre zapatillas de running no debería repetir solo la frase "zapatillas de running", debería cubrir el ajuste, la amortiguación, la pisada, el terreno y el caso de uso cuando sea relevante. Ese tipo de cobertura semántica señala integridad temática sin sonar forzado.
Prueba útil: si un término parecería extraño en un glosario junto al tema de la página, déjalo fuera.
Una segunda táctica es usar los encabezados como señales semánticas. Los H2 y H3 deben reflejar las principales ramas conceptuales del tema, no solo variantes de palabras clave. Eso ayuda a los lectores a escanear la página y ayuda a los sistemas de búsqueda a entender la lógica interna de la misma.
Usa la comparación, no la repetición
Las páginas semánticas más efectivas a menudo se leen como comparaciones cuidadosas. Distinguen ideas relacionadas, aclaran casos límite y responden a las preguntas que es probable que los lectores hagan a continuación. Eso es mejor que repetir una frase en formas ligeramente diferentes.
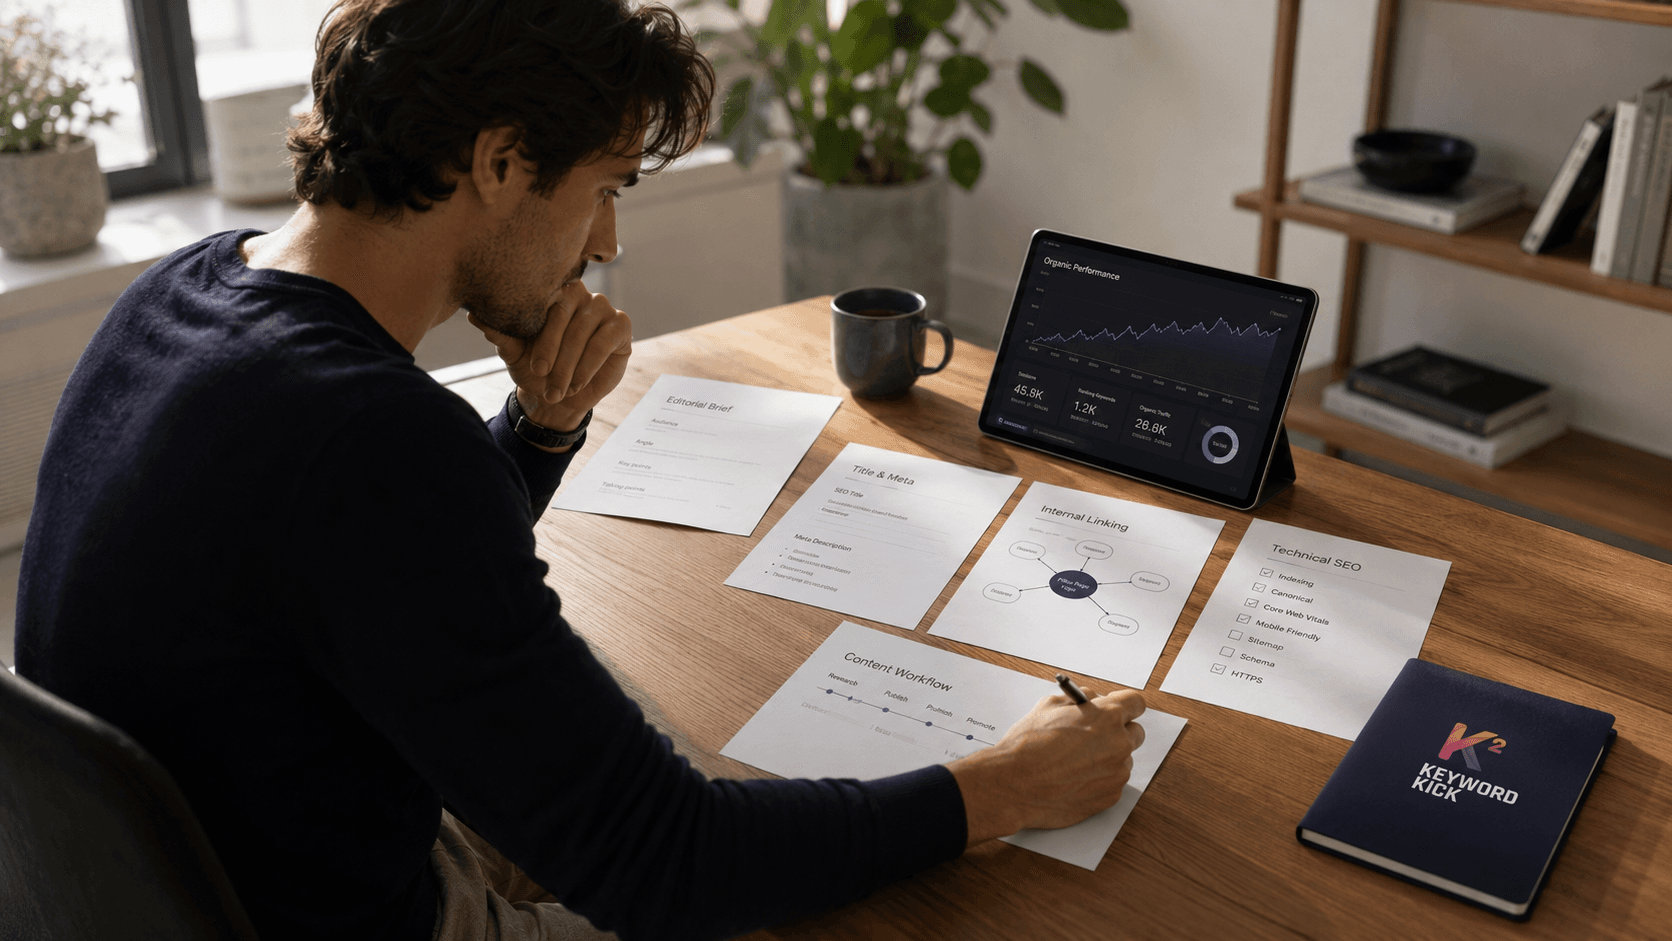
Un flujo de trabajo sencillo funciona bien en páginas existentes:
- Lee la página como un recién llegado. Marca cualquier sección que repita la misma idea sin añadir contexto.
- Revisa las páginas de la competencia. Observa qué subtemas cubren ellos que tu página omite.
- Añade entidades faltantes de forma natural. Úsalas en explicaciones, ejemplos y secciones de apoyo.
- Recorta el lenguaje de relleno. Mantén la página centrada en la tarea o pregunta principal.
- Revisa la cobertura semántica después de editar. Una auditoría semántica debería mostrar que el tema se explica desde varios ángulos, no que está relleno de sinónimos.
Para los equipos que desean un flujo de trabajo de contenido estructurado, esta guía de optimización de contenido es un punto de partida útil.
Equilibra la amplitud con la moderación
La investigación fundamental sobre LSI también estableció que las matrices término-documento se aproximan comúnmente utilizando alrededor de 50–100 factores ortogonales, lo que demuestra que el método trata de equilibrar la reducción con el rendimiento, no de maximizar el volumen artículo de lingüística de Stanford. Esa idea se traduce bien en la redacción SEO. Una cobertura amplia ayuda, pero solo cuando cada concepto añadido se gana su lugar.
Si quieres una regla sencilla, usa esta: añade conceptos que profundicen la respuesta, no palabras que simplemente la decoren. La optimización semántica funciona cuando la página se vuelve más fácil de clasificar y más fácil de confiar.
Conclusión y próximos pasos
La Indexación Semántica Latente comenzó como un método de recuperación de información basado en SVD, patrones de coocurrencia ocultos y aproximación de bajo rango. No es una táctica de relleno de sinónimos y no es una palanca mágica de SEO. Es una base útil para entender por qué el significado, el contexto y la estructura temática importan tanto en la búsqueda.
Esa historia conduce a una conclusión práctica. Los motores modernos utilizan sistemas semánticos mucho más avanzados, pero la lección principal no ha cambiado: las páginas ganan cuando cubren claramente un tema y apoyan ese tema con conceptos relacionados que tienen sentido para los humanos. Si tu equipo ha estado tratando las "palabras clave LSI" como una fórmula, deja de hacerlo y empieza a auditar el contenido en busca de integridad semántica.
Elige una página que sea importante para tu negocio, revisa la cobertura del tema y ajusta la estructura en torno a la intención subyacente detrás de la consulta. Luego, mide si la página se lee mejor, responde de forma más completa y respalda un propósito de búsqueda más claro.
Una llamada a la acción para Keyword Kick.