Le calendrier éditorial de votre équipe est complet, le prochain brief arrive à échéance, et quelqu'un vient de lâcher « mots-clés LSI » dans la conversation Slack comme s'il s'agissait d'un raccourci vers un meilleur classement. Le problème est que de nombreux optimiseurs de contenu poursuivent cette expression sans comprendre la méthode qui se cache derrière. Résultat : ils ajoutent des synonymes maladroits, répètent des termes de manière artificielle et appellent cela de l'optimisation. L'indexation sémantique latente (Latent Semantic Indexing) est bien plus ancienne, plus technique et bien plus intéressante que cela.
Qu'est-ce que l'indexation sémantique latente est une question qui porte sur la manière dont les machines peuvent comprendre le sens à partir de modèles linguistiques, et non seulement par la correspondance exacte des mots. Cette distinction est capitale car elle sépare la théorie réelle de la recherche d'information du mythe marketing selon lequel le LSI serait une tactique de bourrage de mots-clés. Si vous avez déjà dû expliquer à des rédacteurs pourquoi « ajouter simplement plus de mots connexes » n'est pas une stratégie, ce guide est pour vous.
Introduction à l'indexation sémantique
Une équipe de contenu remarque souvent le même schéma. Une page est mal classée, quelqu'un examine les pages concurrentes, et l'équipe conclut que la réponse doit être « plus de mots-clés LSI ». Une ébauche revient remplie de phrases vaguement liées, mais le texte sonne faux et la page ne résout toujours pas le problème du lecteur.
Cette frustration provient généralement d'un malentendu. L'indexation sémantique latente a été introduite comme un moyen de réduire le décalage lexical dans la recherche d'information, en utilisant des indices de concepts dérivés statistiquement au lieu de la correspondance mot à mot, et ce, grâce à la SVD tronquée sur une matrice terme-document article LSI. En termes académiques, il s'agit de découvrir des modèles cachés à travers un corpus entier, et non de saupoudrer des synonymes dans un article de blog.
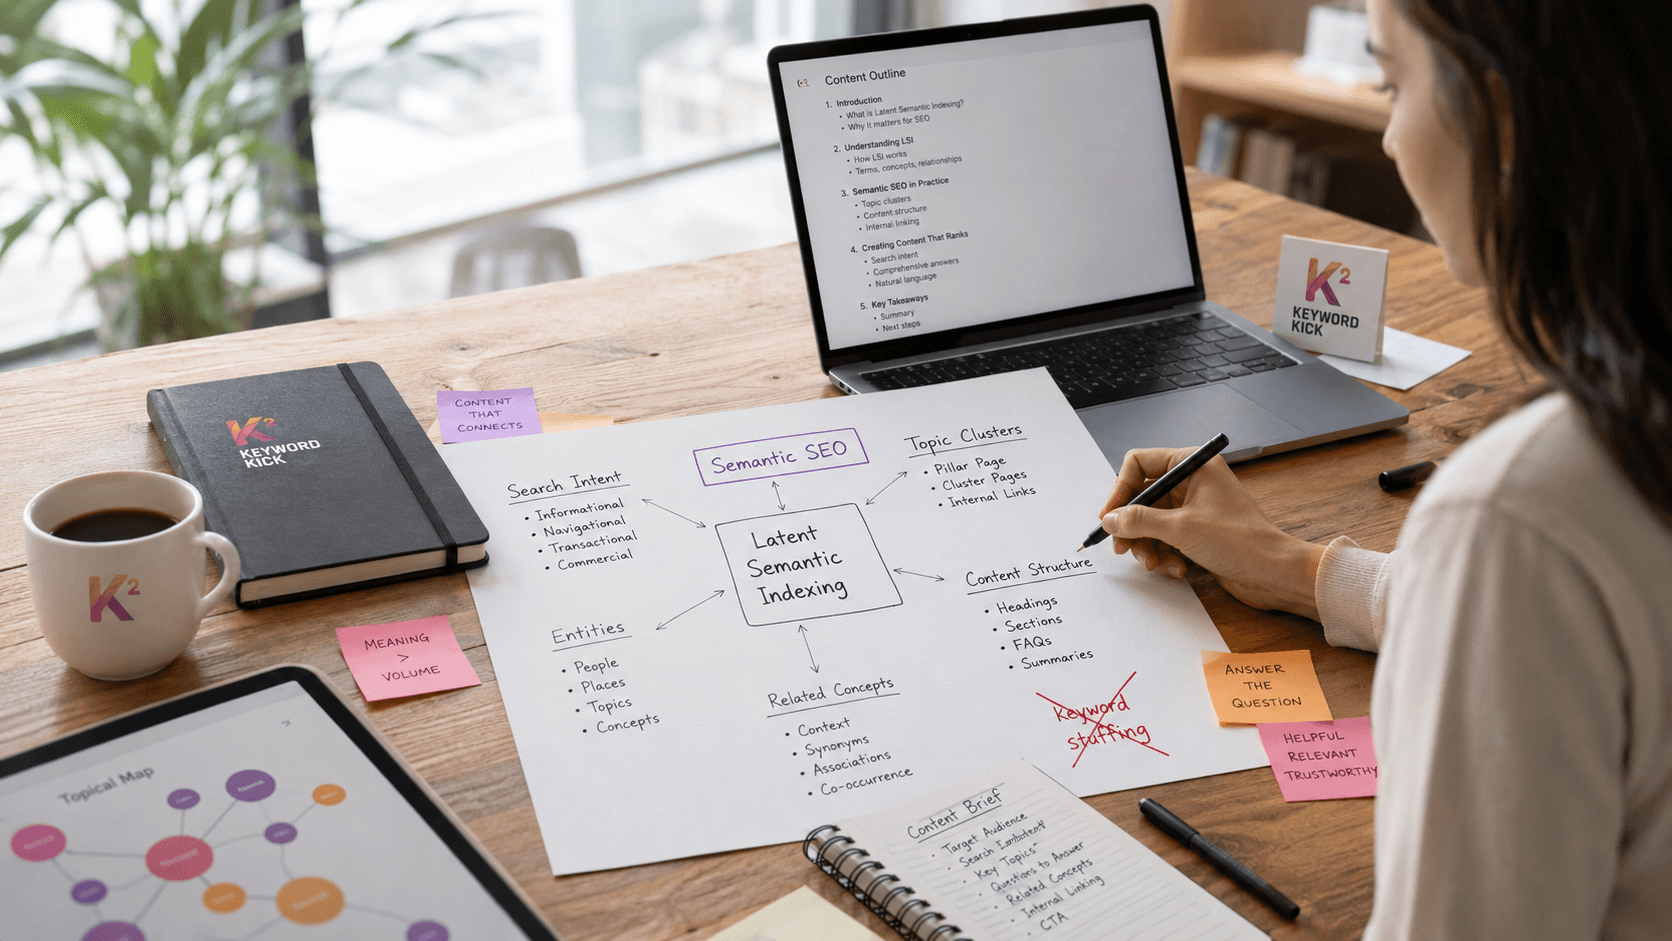
Pour les marketeurs, c'est là le point essentiel. La valeur du LSI ne réside pas dans une astuce de classement magique, mais dans l'idée que le sens peut être déduit du contexte, de la co-occurrence et de la structure thématique. C'est le changement de mentalité dont les équipes ont besoin avant de pouvoir faire du SEO sémantique efficacement.
Comprendre l'indexation sémantique latente
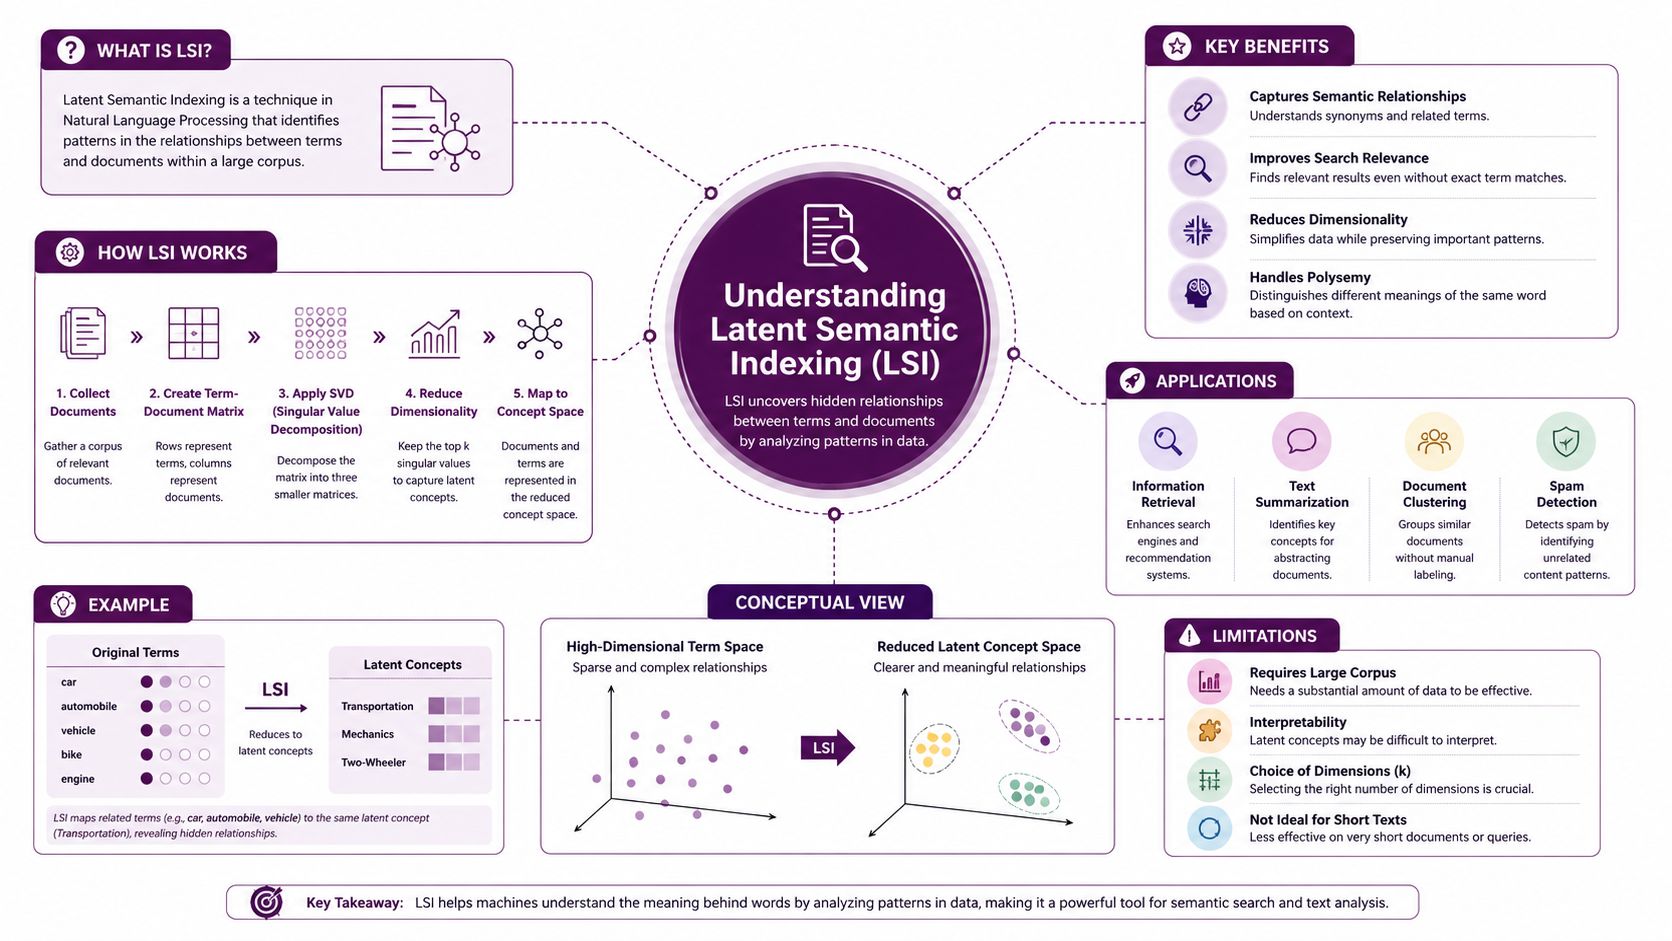
Comment fonctionne la méthode
Imaginez une matrice terme-document comme un tableur géant. Les lignes sont des mots, les colonnes sont des documents, et les chiffres indiquent où les termes apparaissent ensemble. Le LSI applique la décomposition en valeurs singulières (SVD) à cette matrice et la compresse dans un espace sémantique de dimension inférieure, généralement autour de 100 à 300 facteurs latents orthogonaux TREC.
Cette réduction est importante car elle ne se contente pas de réduire les données, elle expose leur structure. Une requête et un document peuvent se retrouver proches dans l'espace latent même s'ils ne partagent pas les mêmes mots en surface, c'est pourquoi le LSI aide à gérer la synonymie et le décalage de vocabulaire. Le manuel de recherche d'information de Stanford décrit cela comme une approximation de rang inférieur de la matrice terme-document, qui maintient une similarité élevée même lorsque le chevauchement exact des termes est faible livre IR Stanford.
Règle pratique : si deux pages utilisent des formulations différentes mais répondent à la même intention, la similarité sémantique peut tout de même les rendre pertinentes.
Pourquoi cela compte pour la pertinence
La façon la plus simple de comprendre le LSI est de le comparer à une lampe de poche dans une pièce sombre. La correspondance brute des termes n'éclaire que les mots que vous voyez directement. Le LSI tente de révéler la forme de la pièce elle-même, les relations cachées qui connectent ces mots à travers de nombreux documents.
C'est pourquoi la méthode est devenue influente dans la recherche documentaire. Une requête sur un terme peut toujours correspondre à un document qui utilise un autre terme, tant que les deux participent à des modèles de co-occurrence similaires dans le corpus article MSU. Si vous souhaitez une taxonomie pratique pour regrouper ces relations thématiques dans la planification de contenu moderne, ce glossaire des clusters thématiques est un compagnon utile.
La confusion centrale pour de nombreuses équipes est de penser que la méthode concerne les mots-clés eux-mêmes. Ce n'est pas le cas. Il s'agit de la géométrie statistique du langage, et c'est pourquoi c'est devenu une idée fondamentale dans les systèmes de recherche bien avant que les experts SEO ne commencent à en parler.
Histoire et relation avec la LSA
D'où vient le LSI
Le LSI est apparu dans le domaine grâce à un article de 1990 de Deerwester et ses collègues, où l'objectif était de remplacer la correspondance mot à mot par des indices de concepts utilisant la SVD tronquée article LSI. Cette origine est importante car elle montre que la méthode a été conçue pour des problèmes de recherche et de regroupement, et non pour du contenu marketing.
Le cadre académique rend également la confusion sur les noms plus facile à comprendre. En pratique, les gens confondent parfois LSI et LSA, mais les sources de ce brief décrivent la même lignée du point de vue de la recherche d'information, axée sur l'approximation matricielle, la co-occurrence cachée et la structure conceptuelle. Le matériel de Stanford met l'accent sur la vue matricielle de rang inférieur, tandis que d'autres notes de cours présentent la même approche comme une technique de réduction de rang basée sur le théorème d'Eckart-Young article linguistique Stanford.
Pourquoi l'histoire compte encore aujourd'hui
Ce contexte est important car il permet d'éviter une erreur SEO courante. Lorsque quelqu'un parle de « mots-clés LSI », il utilise généralement une étiquette marketing vague, et non la méthode académique originale. Les sources académiques fondamentales décrivent le LSI comme une technique de recherche classique basée sur la SVD, et non comme une tactique de bourrage de mots-clés livre IR Stanford.
Cette différence dépasse le simple pinaillage académique. Elle aide les équipes à cesser de traiter la profondeur sémantique comme une liste de synonymes et à commencer à penser comme des architectes de l'information. Si vous avez besoin d'un aperçu pratique de la manière dont ce malentendu se manifeste dans les flux de travail SEO, ce guide du LSI pour les responsables SEO est une référence utile.
La façon la plus simple de se souvenir de l'histoire est la suivante : le LSI a commencé comme une solution mathématique au bruit dans la recherche, et non comme un hack de marketing de contenu. Une fois que cela est clair, le reste de la conversation SEO devient beaucoup plus facile à évaluer.
Démystifier les mythes sur les mots-clés LSI
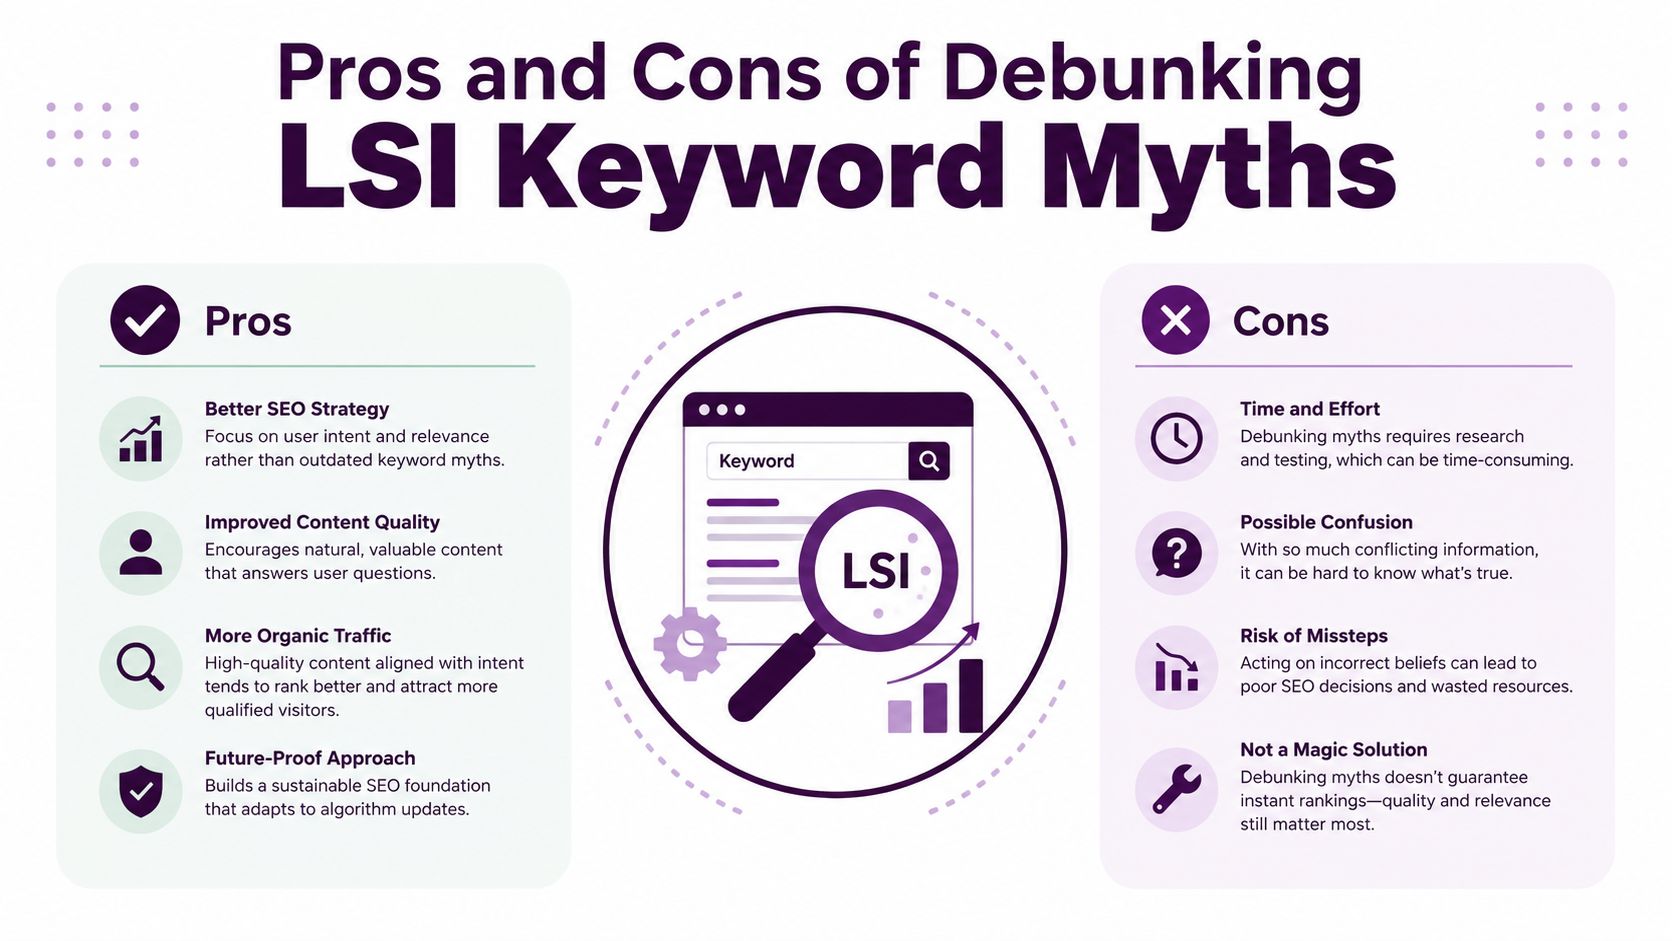
Les mythes que les équipes continuent de répéter
Le premier mythe est que les mots-clés LSI sont une liste formelle de phrases que vous pouvez extraire et insérer pour obtenir un meilleur classement. Ce cadre réduit la méthode académique à un gadget de contenu, ce contre quoi le livre IR de Stanford met en garde en traitant le LSI comme une approximation matricielle de rang inférieur pour la recherche, et non comme une formule de mots-clés livre IR Stanford.
Le deuxième mythe est qu'ajouter plus de termes connexes renforce automatiquement une page. En réalité, les listes de synonymes forcées affaiblissent souvent la clarté, ce qui est l'opposé de ce que la recherche sémantique tente d'atteindre. Le LSI consiste à capturer des relations dans un corpus, et non à rendre chaque paragraphe artificiellement large.
Le troisième mythe est que l'expression elle-même décrit encore un mécanisme de classement SEO actif. C'est pourquoi de nombreux articles l'appellent une tactique moderne alors que les sources académiques fondamentales la présentent comme une méthode IR classique construite sur la SVD livre IR Stanford. Si vous souhaitez comparer cette idée fausse avec le langage SEO plus large, la discussion sur le classement du contenu dans les réponses IA de MyMentions montre pourquoi la couverture sémantique compte plus que les étiquettes de mots-clés obsolètes.
Ce qu'il faut arrêter de faire
- Arrêtez de créer des listes de synonymes. Si la formulation n'aide pas le lecteur à comprendre le sujet, c'est du remplissage.
- Arrêtez de traiter la densité comme un indicateur de profondeur. La pertinence sémantique vient de la couverture, de la structure et de l'alignement avec l'intention.
- Arrêtez de supposer que « termes connexes » signifie variations aléatoires. Une bonne rédaction sémantique utilise des entités et des concepts qui font partie intégrante du sujet.
Une page peut mentionner plus de termes et rester moins utile si la rédaction perd son focus.
Un meilleur modèle consiste à utiliser le LSI comme une lentille, pas comme une liste de contrôle. La lentille vous indique que le sens est contextuel, mais elle n'excuse pas un texte bâclé. Le SEO sémantique fonctionne lorsque la page répond clairement à la requête, puis renforce cette réponse avec des concepts de soutien qui s'intègrent naturellement.
Comment les moteurs de recherche interprètent la sémantique
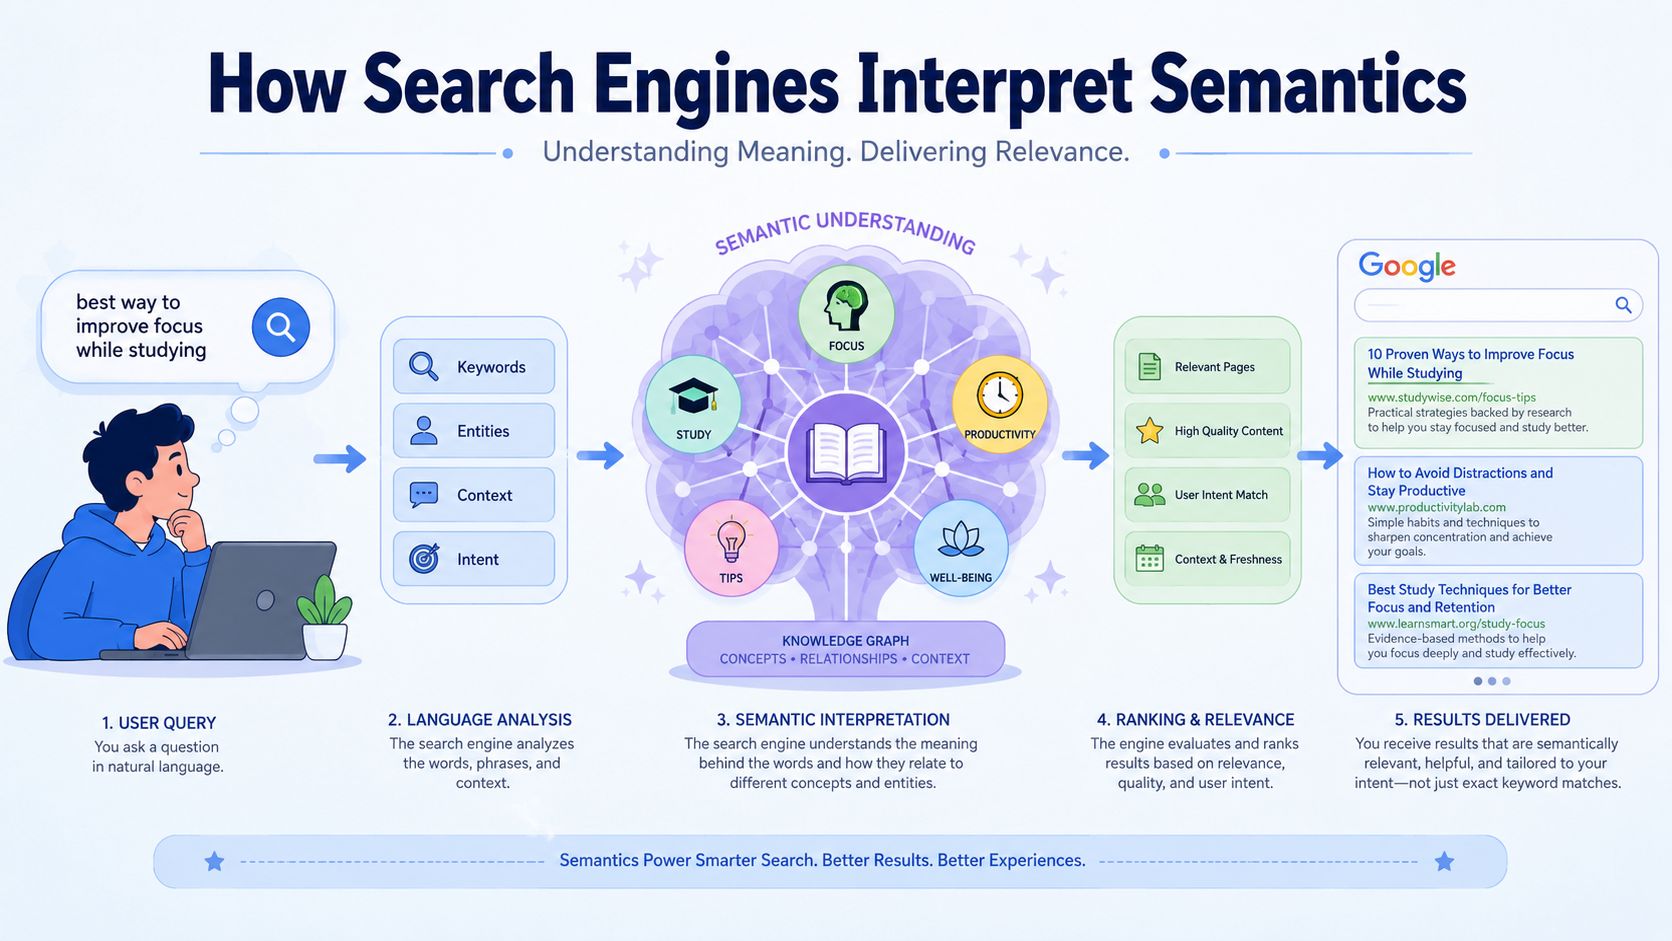
Des matrices au sens
Les moteurs de recherche modernes ne reposent pas sur l'algorithme LSI original, mais ils poursuivent le même objectif général : comprendre le sens au-delà du chevauchement exact des mots. Le modèle LSI historique utilisait la SVD sur une matrice terme-document pour déduire une structure latente TREC. Les systèmes de recherche actuels utilisent des méthodes sémantiques beaucoup plus avancées, mais le principe est familier : le contexte compte.
Ce changement explique pourquoi une requête peut être interprétée correctement même lorsque la page ne la répète pas mot pour mot. Les moteurs utilisent désormais des signaux contextuels, la reconnaissance d'entités et des représentations vectorielles pour décider si un résultat correspond à l'intention de l'utilisateur. L'ancienne approche de factorisation matricielle est un modèle mental utile, mais ce n'est pas la couche de classement en temps réel.
Pourquoi le contexte bat la correspondance exacte
Les marketeurs sur-corrigent souvent. Ils entendent dire que les moteurs de recherche « comprennent la sémantique » et supposent que chaque page a besoin d'une pile de mots connexes. Ce qui aide, c'est une rédaction qui établit clairement le sujet, le sous-sujet et l'intention, afin que le moteur puisse placer la page dans le bon voisinage conceptuel.
C'est aussi pourquoi le maillage interne et l'organisation thématique comptent tant. Si une page renforce systématiquement un concept à travers les titres, le corps du texte et les pages connexes, elle donne aux systèmes de recherche des preuves plus solides sur l'objet de la page. Pour un aperçu pratique de la façon dont les systèmes modernes interprètent et réutilisent les signaux thématiques, l'entrée du glossaire RankBrain est un pont utile entre les idées IR classiques et le comportement de classement moderne.
Comment penser à la recherche à l'ère de l'IA
La recherche est désormais plus conversationnelle et plus sensible au contexte que les systèmes qui ont rendu le LSI célèbre. Cela ne rend pas le LSI obsolète en tant que concept, cela le rend historiquement important. Il a donné aux marketeurs l'une des premières explications claires sur les raisons pour lesquelles la pensée basée sur la correspondance exacte échoue lorsque le langage est complexe.
Si vous optimisez pour les réponses IA ou les expériences de recherche enrichies, l'état d'esprit reste le même. Couvrez le sujet avec précision, utilisez des termes qui appartiennent au même champ conceptuel et évitez de forcer des mots simplement parce qu'ils semblent adjacents. Pour un regard plus approfondi sur ce changement dans les environnements SERP pratiques, consultez le classement du contenu dans les réponses IA de MyMentions.
Optimiser le contenu avec des techniques sémantiques
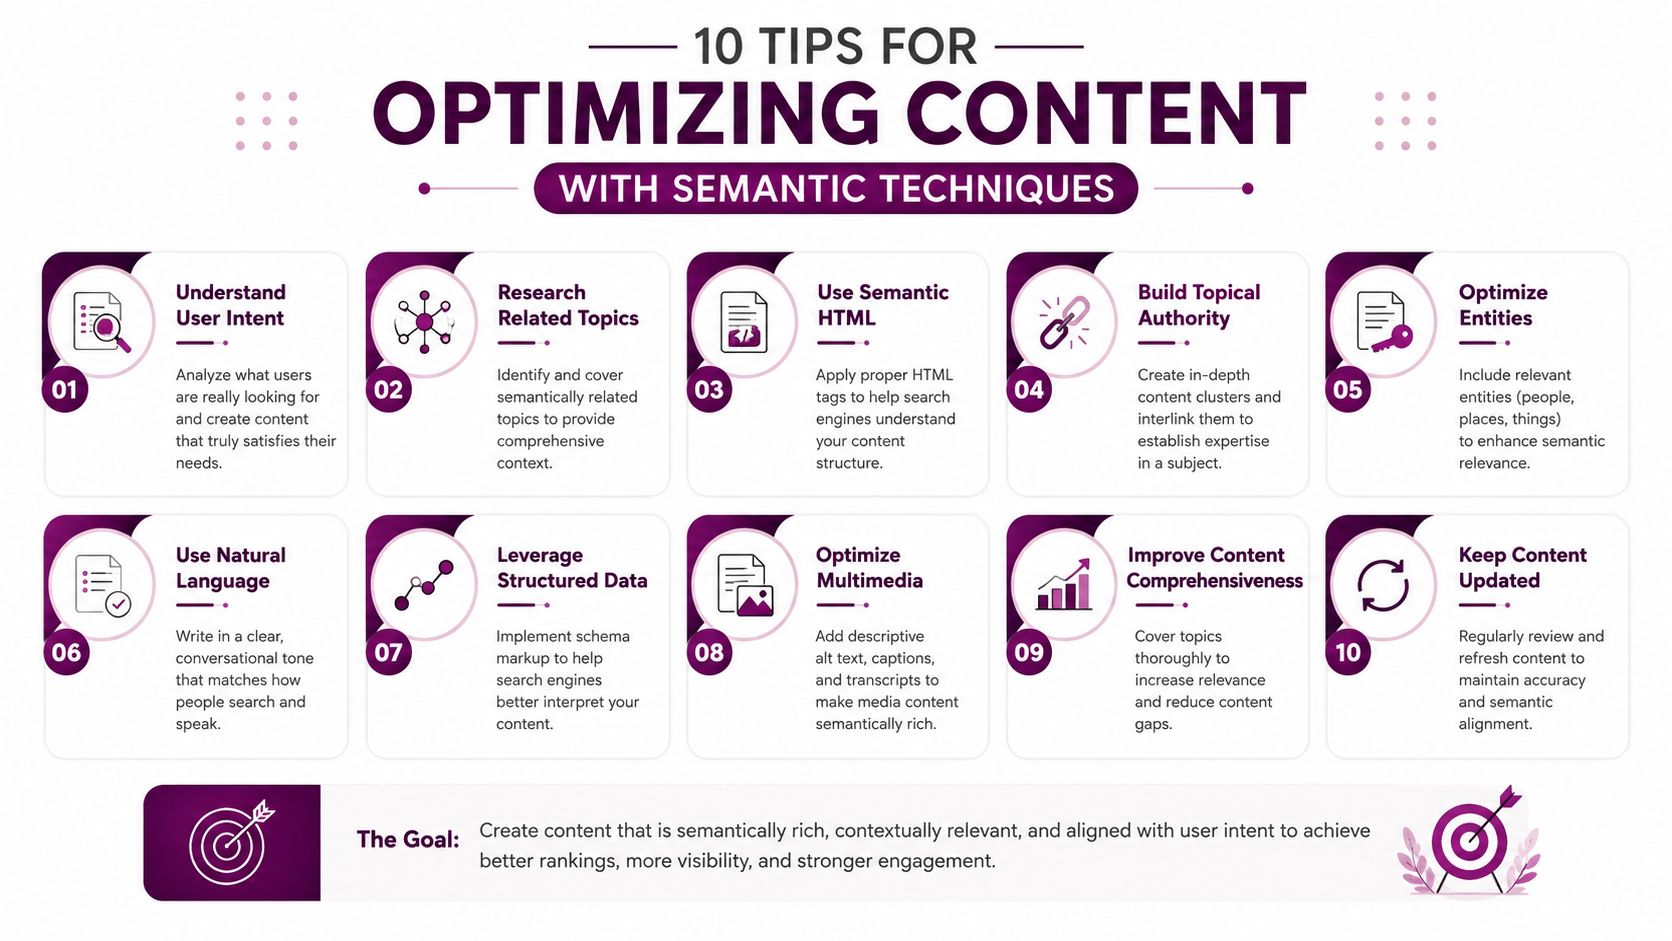
Construire autour d'une structure thématique
Commencez par une page qui répond à une intention principale, puis mappez les entités liées qui appartiennent naturellement à côté. Une page produit sur des chaussures de course ne devrait pas simplement répéter l'expression « chaussures de course », elle devrait couvrir l'ajustement, l'amorti, la foulée, le terrain et le cas d'utilisation le cas échéant. Ce type de couverture sémantique signale une exhaustivité thématique sans paraître forcé.
Test utile : si un terme semble étrange dans un glossaire à côté du sujet de la page, laissez-le de côté.
Une deuxième tactique consiste à utiliser les titres comme des panneaux de signalisation sémantiques. Les H2 et H3 doivent refléter les principales branches conceptuelles du sujet, et non simplement des variantes de mots-clés. Cela aide les lecteurs à scanner la page et aide les systèmes de recherche à comprendre la logique interne de la page.
Utiliser la comparaison, pas la répétition
Les pages sémantiques les plus efficaces se lisent souvent comme des comparaisons minutieuses. Elles distinguent les idées connexes, clarifient les cas limites et répondent aux questions que les lecteurs sont susceptibles de poser ensuite. C'est mieux que de répéter une expression sous des formes légèrement différentes.
Un flux de travail simple fonctionne bien sur les pages existantes :
- Lisez la page comme un nouveau venu. Marquez toutes les sections qui répètent la même idée sans ajouter de contexte.
- Vérifiez les pages concurrentes. Notez les sous-sujets qu'elles couvrent et que votre page manque.
- Ajoutez les entités manquantes naturellement. Utilisez-les dans les explications, les exemples et les sections de soutien.
- Éliminez le langage de remplissage. Gardez la page concentrée sur la tâche ou la question principale.
- Révisez la couverture sémantique après l'édition. Un audit sémantique doit montrer que le sujet est expliqué sous plusieurs angles, et non rempli de synonymes.
Pour les équipes qui souhaitent un flux de travail de contenu structuré, ce guide d'optimisation de contenu est un point de départ utile.
Équilibrer l'étendue avec la retenue
La recherche fondamentale sur le LSI a également établi que les matrices terme-document sont couramment approximées en utilisant environ 50 à 100 facteurs orthogonaux, ce qui montre que la méthode consiste à équilibrer la réduction avec la performance, et non à maximiser le volume article linguistique Stanford. Cette idée se traduit bien dans la rédaction SEO. Une large couverture aide, mais seulement lorsque chaque concept ajouté gagne sa place.
Si vous voulez une règle simple, utilisez celle-ci : ajoutez des concepts qui approfondissent la réponse, pas des mots qui ne font que la décorer. L'optimisation sémantique fonctionne lorsque la page devient plus facile à classer et plus facile à faire confiance.
Conclusion et prochaines étapes
L'indexation sémantique latente a commencé comme une méthode de recherche d'information basée sur la SVD, les modèles de co-occurrence cachés et l'approximation de rang inférieur. Ce n'est pas une tactique de bourrage de synonymes, et ce n'est pas un levier SEO magique. C'est une base utile pour comprendre pourquoi le sens, le contexte et la structure thématique comptent tant dans la recherche.
Cette histoire mène à une conclusion pratique. Les moteurs modernes utilisent des systèmes sémantiques beaucoup plus avancés, mais la leçon fondamentale reste inchangée : les pages gagnent lorsqu'elles couvrent clairement un sujet et soutiennent ce sujet avec des concepts connexes qui ont du sens pour les humains. Si votre équipe traite les « mots-clés LSI » comme une formule, arrêtez de le faire et commencez plutôt à auditer le contenu pour son exhaustivité sémantique.
Choisissez une page importante pour votre entreprise, passez en revue la couverture du sujet et resserrez la structure autour de l'intention sous-jacente à la requête. Ensuite, mesurez si la page se lit mieux, répond plus complètement et soutient un objectif de recherche plus clair.
Un CTA pour Keyword Kick.