Il calendario editoriale del tuo team è pieno, il prossimo brief è in scadenza e qualcuno ha appena buttato lì “keyword LSI” nella chat di Slack come se fosse una scorciatoia per posizionarsi meglio. Il problema è che molti ottimizzatori di contenuti inseguono questa espressione senza comprenderne il metodo sottostante, finendo per aggiungere sinonimi fuori contesto, ripetere termini in modo innaturale e chiamarlo ottimizzazione. La Latent Semantic Indexing è più datata, più tecnica e molto più interessante di così.
Cos'è la Latent Semantic Indexing è una domanda su come le macchine riescano a comprendere il significato dai pattern del linguaggio, non solo dalla corrispondenza esatta delle parole. Questa distinzione è fondamentale perché separa la vera teoria del recupero delle informazioni dal mito del marketing secondo cui la LSI sarebbe una tattica di keyword stuffing. Se hai mai dovuto spiegare agli autori perché “aggiungere solo più parole correlate” non è una strategia, questa guida fa per te.
Introduzione alla Semantic Indexing
Un team di contenuti nota spesso lo stesso schema. Una pagina si posiziona male, qualcuno analizza le pagine dei competitor e il gruppo decide che la risposta deve essere “più keyword LSI”. Torna una bozza piena di frasi vagamente correlate, ma il testo suona male e la pagina continua a non risolvere il problema del lettore.
Quella frustrazione nasce solitamente da un malinteso. La Latent Semantic Indexing è stata introdotta come metodo per ridurre il lexical mismatch nel recupero delle informazioni, utilizzando indici di concetti derivati statisticamente invece della corrispondenza di singole parole, e lo fa attraverso la SVD troncata su una matrice termine-documento documento LSI. In termini accademici, si tratta di scoprire pattern nascosti in un intero corpus, non di spargere sinonimi in un post del blog.
Per i marketer, questa distinzione è il punto chiave. Il valore della LSI non risiede in un trucco magico per il ranking, ma nell'idea che il significato possa essere dedotto dal contesto, dalla co-occorrenza e dalla struttura dell'argomento. È questo il cambio di mentalità necessario ai team prima di poter fare una buona SEO semantica.
Comprendere la Latent Semantic Indexing
Come funziona il metodo
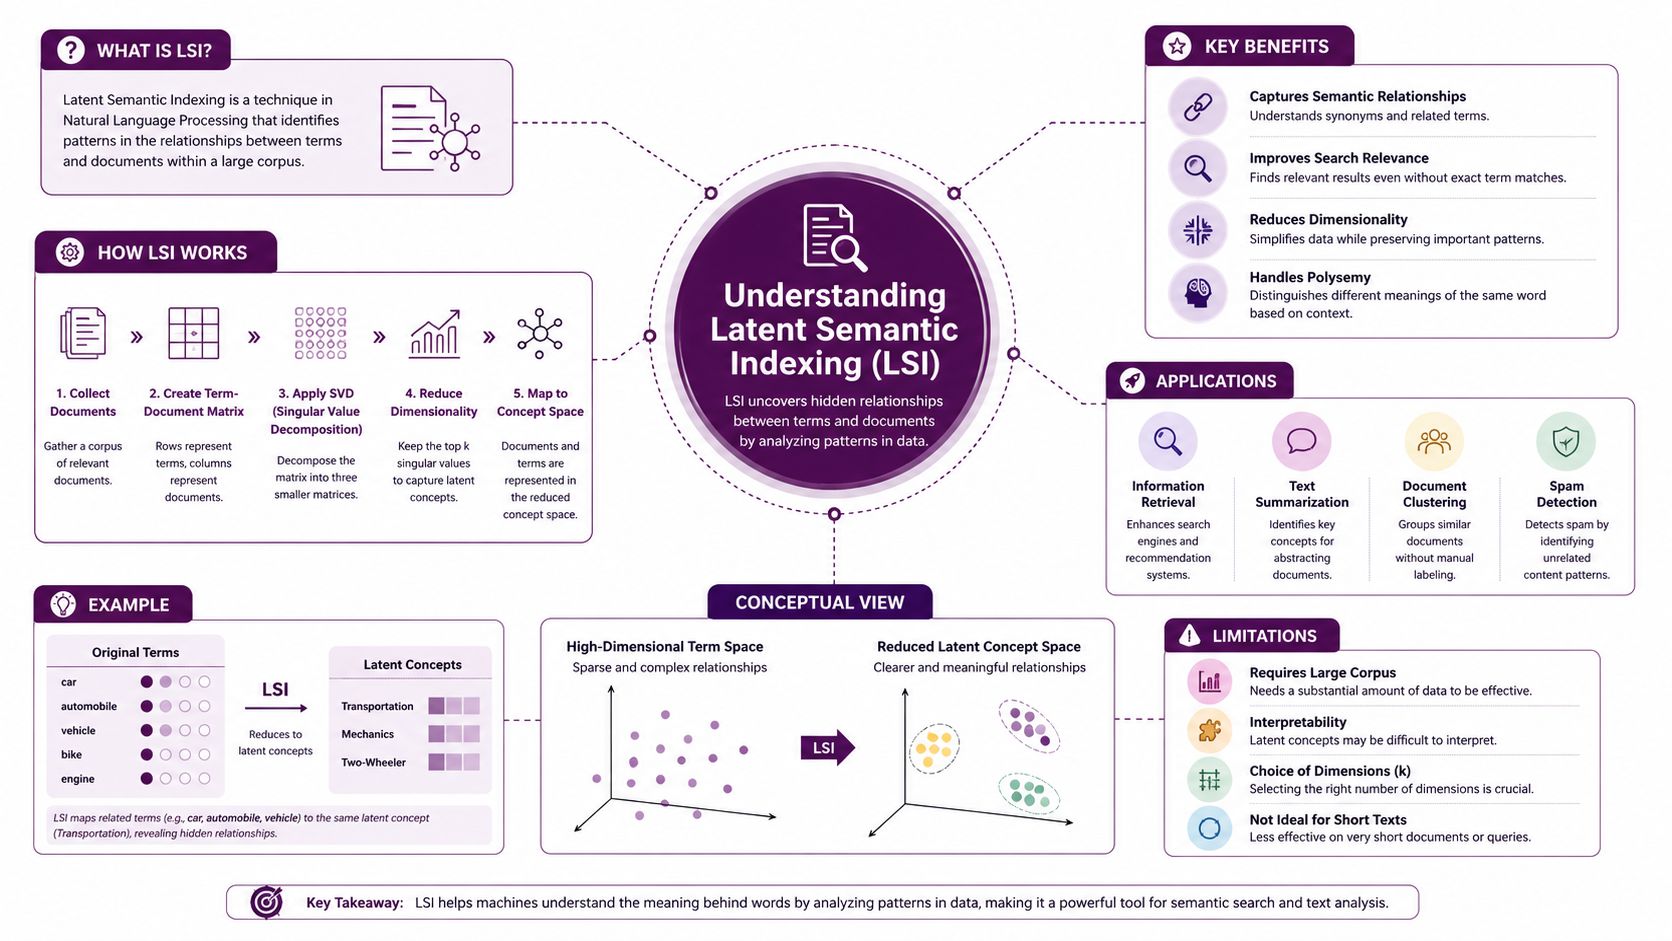
Immagina una matrice termine-documento come un enorme foglio di calcolo. Le righe sono parole, le colonne sono documenti e i numeri mostrano dove i termini appaiono insieme. La LSI applica la decomposizione ai valori singolari (SVD) a quella matrice e la comprime in uno spazio semantico a dimensione ridotta, tipicamente intorno ai 100–300 fattori latenti ortogonali TREC.
Questa riduzione è importante perché non si limita a restringere i dati, ma ne espone la struttura. Una query e un documento possono posizionarsi vicini nello spazio latente anche quando non condividono le stesse parole superficiali; ecco perché la LSI aiuta con la sinonimia e il disallineamento del vocabolario. Il libro di testo di Stanford sull'IR la descrive come un'approssimazione a basso rango della matrice termine-documento, che mantiene alta la similarità anche quando la sovrapposizione esatta dei termini è bassa libro Stanford IR.
Regola pratica: se due pagine usano una formulazione diversa ma rispondono allo stesso intento, la similarità semantica può comunque renderle correlate.
Perché è importante per la pertinenza
Il modo più semplice per capire la LSI è confrontarla con una torcia in una stanza buia. La corrispondenza grezza dei termini illumina solo le parole che vedi direttamente. La LSI cerca di rivelare la forma della stanza stessa, le relazioni nascoste che collegano quelle parole in molti documenti.
Ecco perché il metodo è diventato influente nella ricerca sul recupero delle informazioni. Una query su un termine può corrispondere a un documento che ne usa un altro, purché entrambi partecipino a pattern di co-occorrenza simili nel corpus documento MSU. Se desideri una tassonomia pratica per raggruppare quelle relazioni tematiche nella pianificazione dei contenuti moderna, un utile compagno è questo glossario sui topic cluster.
La confusione principale per molti team è pensare che il metodo riguardi le keyword in sé. Non è così. Riguarda la geometria statistica del linguaggio, ed è per questo che è diventata un'idea fondamentale nei sistemi di recupero molto prima che gli esperti SEO iniziassero a parlarne.
Storia e relazione con la LSA
Le origini della LSI
La LSI è entrata nel campo attraverso un documento del 1990 di Deerwester e colleghi, dove l'obiettivo era sostituire la corrispondenza di singole parole con indici di concetti utilizzando la SVD troncata documento LSI. Quell'origine è importante perché dimostra che il metodo è stato progettato per problemi di recupero e clustering, non per testi di marketing.
L'inquadramento accademico rende anche più facile comprendere la confusione sui nomi. In pratica, le persone a volte confondono LSI e LSA, ma le fonti in questo brief descrivono la stessa discendenza dal punto di vista del recupero delle informazioni, focalizzata sull'approssimazione di matrici, co-occorrenza nascosta e struttura dei concetti. Il materiale di Stanford enfatizza la visione della matrice a basso rango, mentre altre note di lezione inquadrano lo stesso approccio come una tecnica di riduzione del rango basata sul teorema di Eckart-Young documento di linguistica di Stanford.
Perché la storia è ancora importante oggi
Questo background è importante perché blocca un errore SEO comune. Quando qualcuno dice “keyword LSI”, solitamente usa un'etichetta di marketing generica, non il metodo accademico originale. Le fonti accademiche principali descrivono la LSI come una classica tecnica di recupero basata su SVD, non come una tattica di keyword stuffing libro Stanford IR.
Questa differenza è più di un semplice tecnicismo accademico. Aiuta i team a smettere di trattare la profondità semantica come una lista di controllo di sinonimi e a iniziare a pensare come architetti dell'informazione. Se hai bisogno di una panoramica pratica su come questo malinteso si manifesta nei flussi di lavoro SEO, questa guida alla LSI per SEO manager è un utile punto di riferimento.
Il modo più chiaro per ricordare la storia è questo: la LSI è nata come soluzione matematica al rumore nel recupero, non come un trucco di content marketing. Una volta chiarito questo, il resto della conversazione SEO diventa molto più facile da valutare.
Sfatare i miti sulle keyword LSI
I miti che i team continuano a ripetere
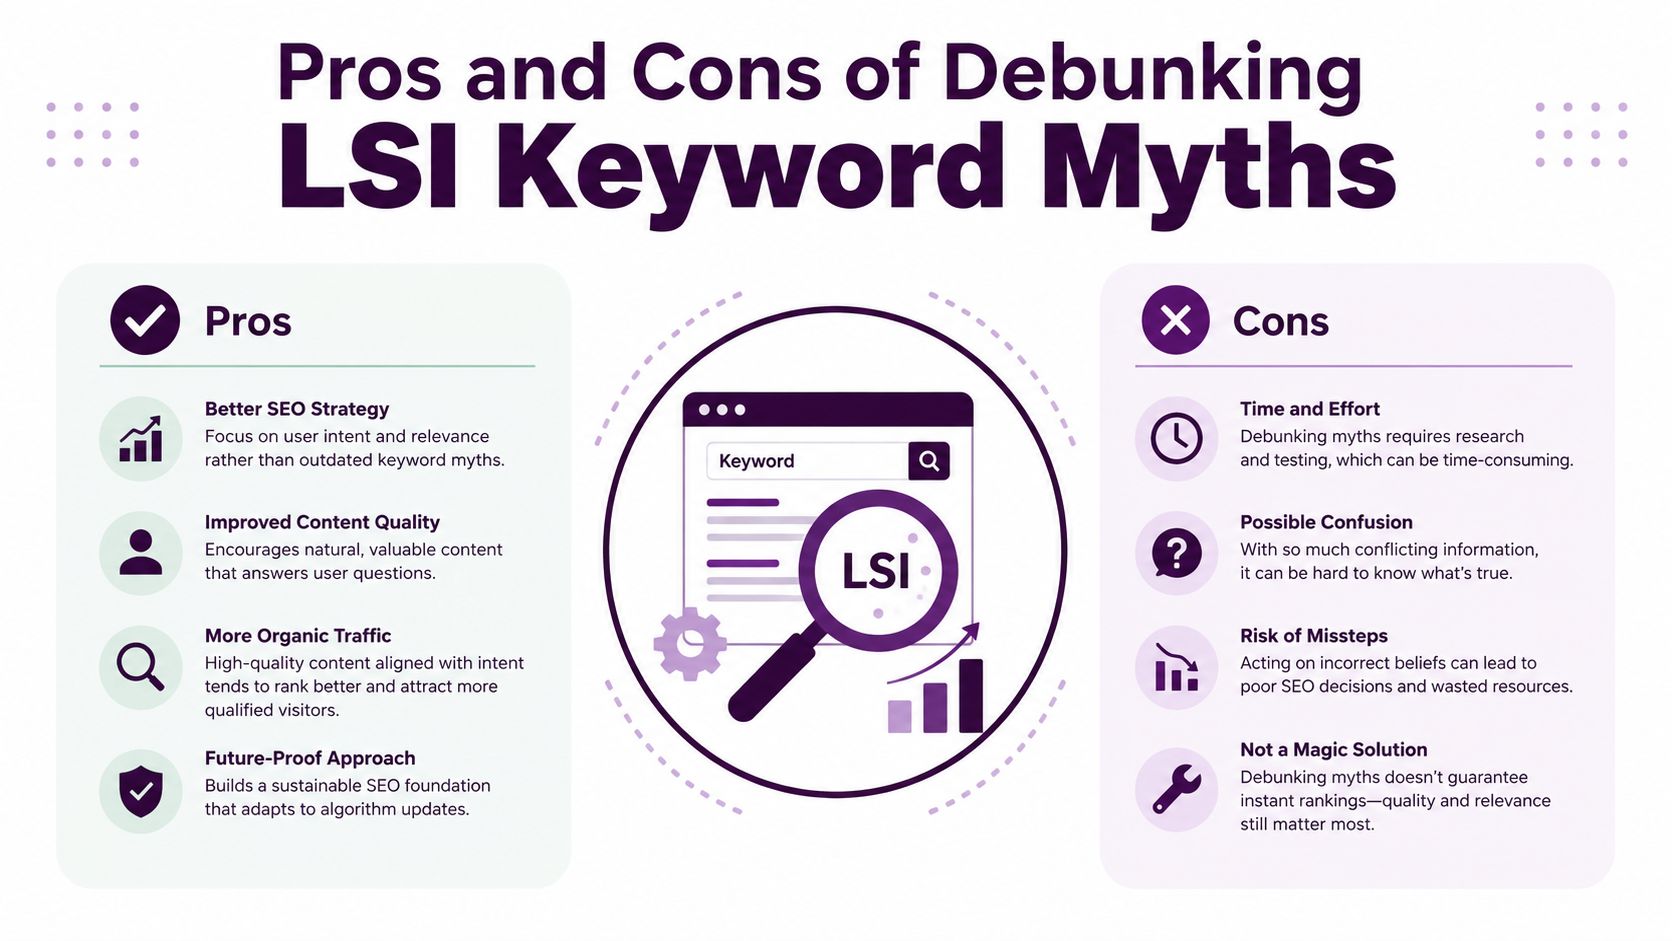
Il primo mito è che le keyword LSI siano un elenco formale di frasi che puoi estrarre e inserire per migliorare il posizionamento. Questo inquadramento riduce il metodo accademico a un espediente di contenuto, che è esattamente ciò contro cui mette in guardia il libro di Stanford sull'IR, trattando la LSI come approssimazione di matrice a basso rango per il recupero, non come una formula di keyword libro Stanford IR.
Il secondo mito è che aggiungere più termini correlati renda automaticamente una pagina più forte. In realtà, liste di sinonimi forzate spesso indeboliscono la chiarezza, che è l'opposto di ciò che il recupero semantico cerca di ottenere. La LSI riguarda la cattura delle relazioni in un corpus, non il rendere ogni paragrafo artificialmente ampio.
Il terzo mito è che l'espressione stessa descriva ancora un meccanismo di ranking SEO attivo. Ecco perché molti articoli la chiamano tattica moderna, quando le fonti accademiche principali la inquadrano come un classico metodo IR basato su SVD libro Stanford IR. Se vuoi confrontare questa idea errata con un linguaggio SEO più ampio, la discussione sul posizionamento dei contenuti nelle risposte AI di MyMentions mostra perché la copertura semantica conta più delle etichette di keyword obsolete.
Cosa smettere di fare
- Smetti di creare liste di sinonimi. Se la formulazione non aiuta il lettore a comprendere l'argomento, è solo riempitivo.
- Smetti di trattare la densità come proxy della profondità. La pertinenza semantica deriva dalla copertura, dalla struttura e dall'allineamento dell'intento.
- Smetti di dare per scontato che “termini correlati” significhi variazioni casuali. Una buona scrittura semantica utilizza entità e concetti integrali all'argomento.
Una pagina può menzionare più termini e risultare comunque meno utile se la scrittura perde il focus.
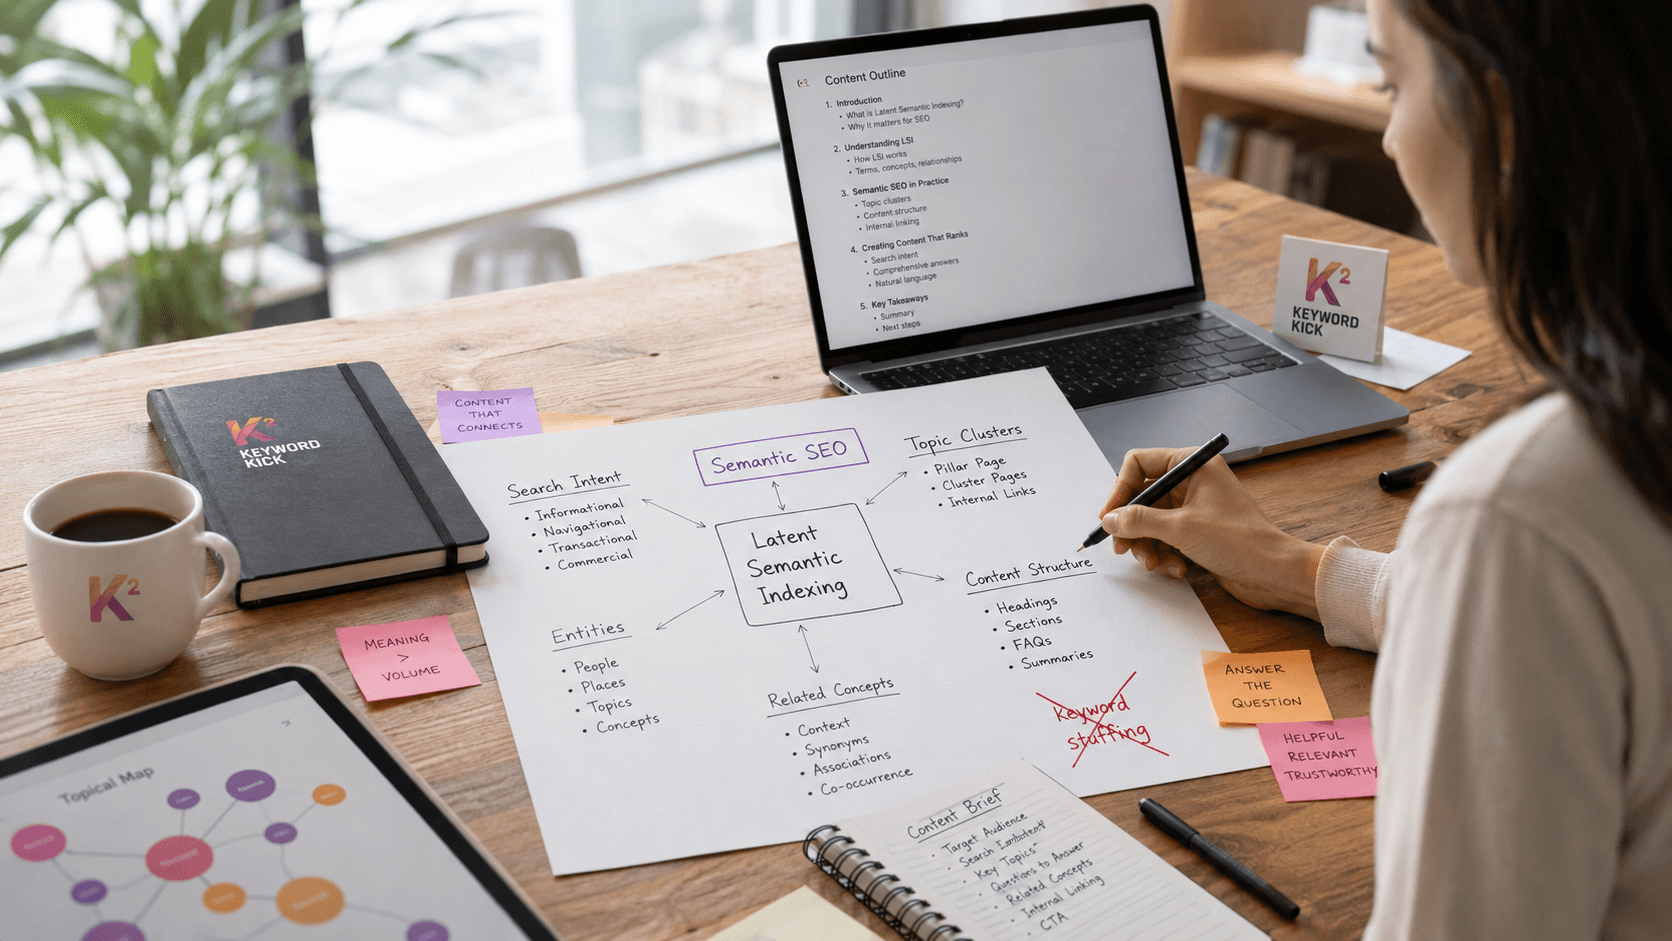
Un modello migliore è usare la LSI come una lente, non come una lista di controllo. La lente ti dice che il significato è contestuale, ma non giustifica testi trascurati. La SEO semantica funziona quando la pagina risponde chiaramente alla query, rafforzando poi quella risposta con concetti di supporto che si inseriscono naturalmente.
Come i motori di ricerca interpretano la semantica
Dalle matrici al significato
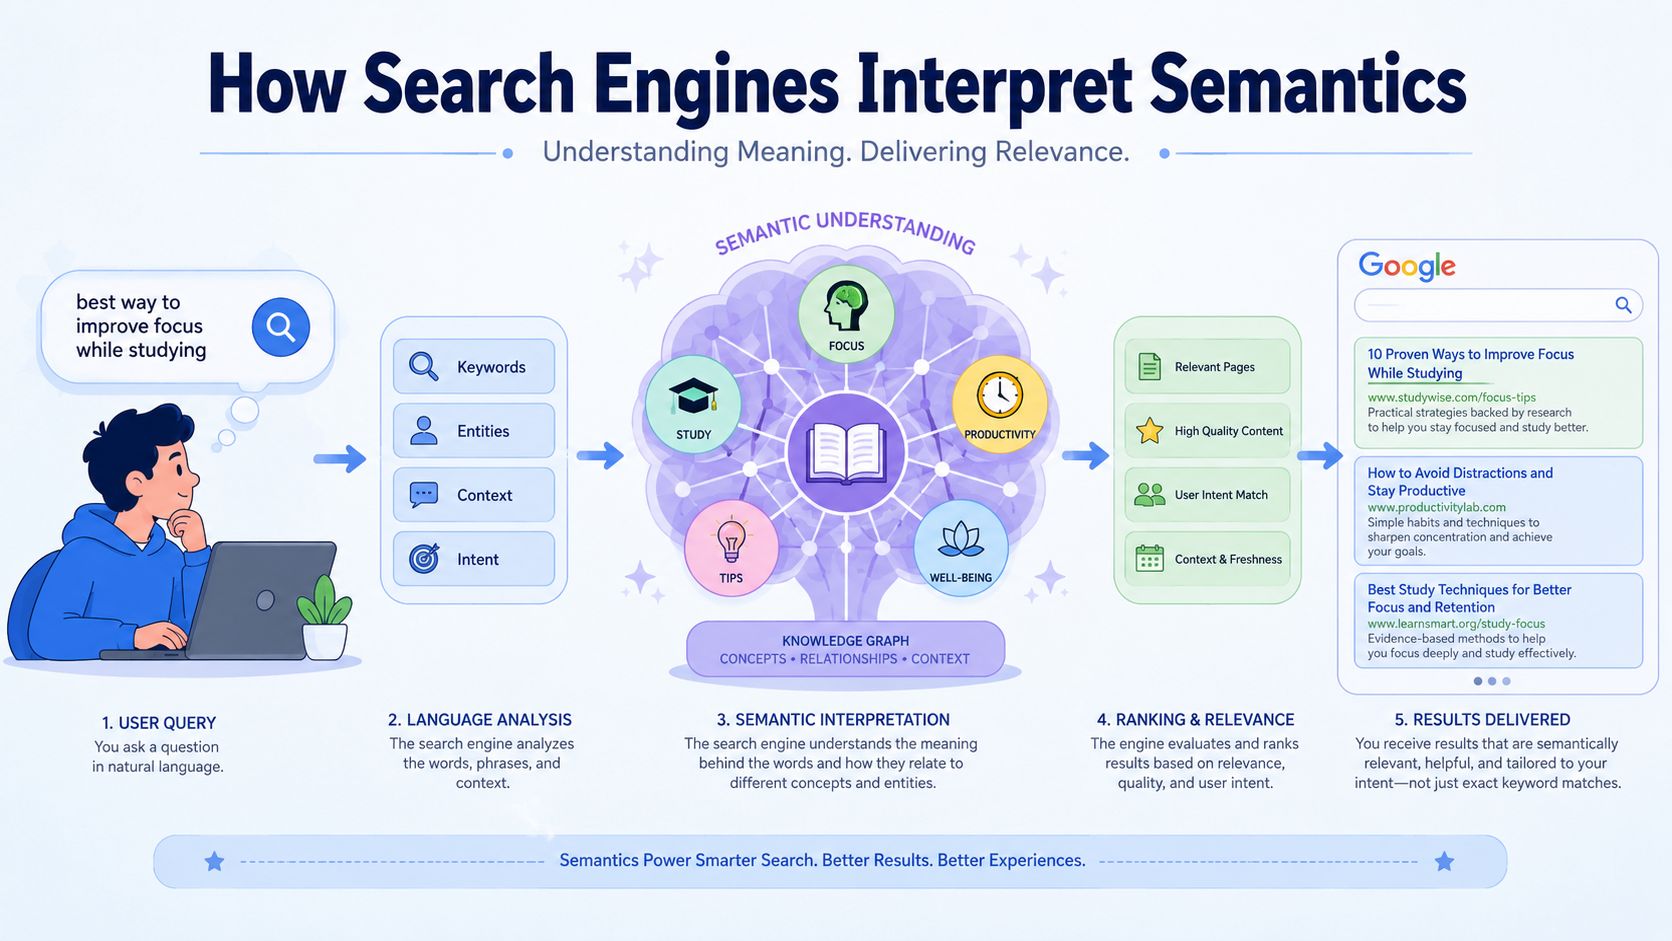
I moderni motori di ricerca non si basano sull'algoritmo LSI originale, ma perseguono lo stesso ampio obiettivo: comprendere il significato oltre la sovrapposizione esatta delle parole. Il modello LSI storico utilizzava la SVD su una matrice termine-documento per dedurre la struttura latente TREC. I sistemi di ricerca odierni utilizzano metodi semantici molto più avanzati, ma il principio è familiare: il contesto conta.
Questo cambiamento è il motivo per cui una query può essere interpretata correttamente anche quando la pagina non la ripete parola per parola. I motori ora utilizzano segnali di contesto, riconoscimento di entità e rappresentazioni basate su vettori per decidere se un risultato corrisponde all'intento dell'utente. Il vecchio approccio della fattorizzazione di matrici è un utile modello mentale, ma non è il livello di ranking attivo.
Perché il contesto batte la corrispondenza esatta
I marketer spesso correggono eccessivamente. Sentono che i motori di ricerca “comprendono la semantica” e presumono che ogni pagina abbia bisogno di una pila di parole correlate. Ciò che aiuta è una scrittura che stabilisca chiaramente argomento, sotto-argomento e intento, in modo che il motore possa collocare la pagina nel giusto ambito concettuale.
Ecco anche perché il link building interno e l'organizzazione tematica contano così tanto. Se una pagina rafforza costantemente un concetto attraverso titoli, corpo del testo e pagine correlate, fornisce ai sistemi di ricerca prove più forti su ciò che la pagina rappresenta. Per uno sguardo pratico su come i sistemi moderni interpretano e riutilizzano i segnali tematici, la voce del glossario su RankBrain è un ponte utile tra le idee classiche dell'IR e il comportamento di ranking moderno.
Come pensare alla ricerca nell'era dell'AI
La ricerca è ora più colloquiale e sensibile al contesto rispetto ai sistemi che hanno reso famosa la LSI. Questo non rende la LSI obsoleta come concetto, la rende storicamente importante. Ha fornito ai marketer una delle prime spiegazioni chiare sul perché il pensiero basato sulla corrispondenza esatta fallisce quando il linguaggio è disordinato.
Se stai ottimizzando per risposte AI o esperienze di ricerca avanzate, la mentalità è sempre la stessa. Copri l'argomento con precisione, usa termini che appartengono allo stesso campo concettuale ed evita di forzare parole solo perché suonano adiacenti. Per uno sguardo più approfondito a questo cambiamento negli ambienti SERP pratici, vedi posizionamento dei contenuti nelle risposte AI di MyMentions.
Ottimizzare i contenuti con tecniche semantiche
Costruire attorno alla struttura dell'argomento
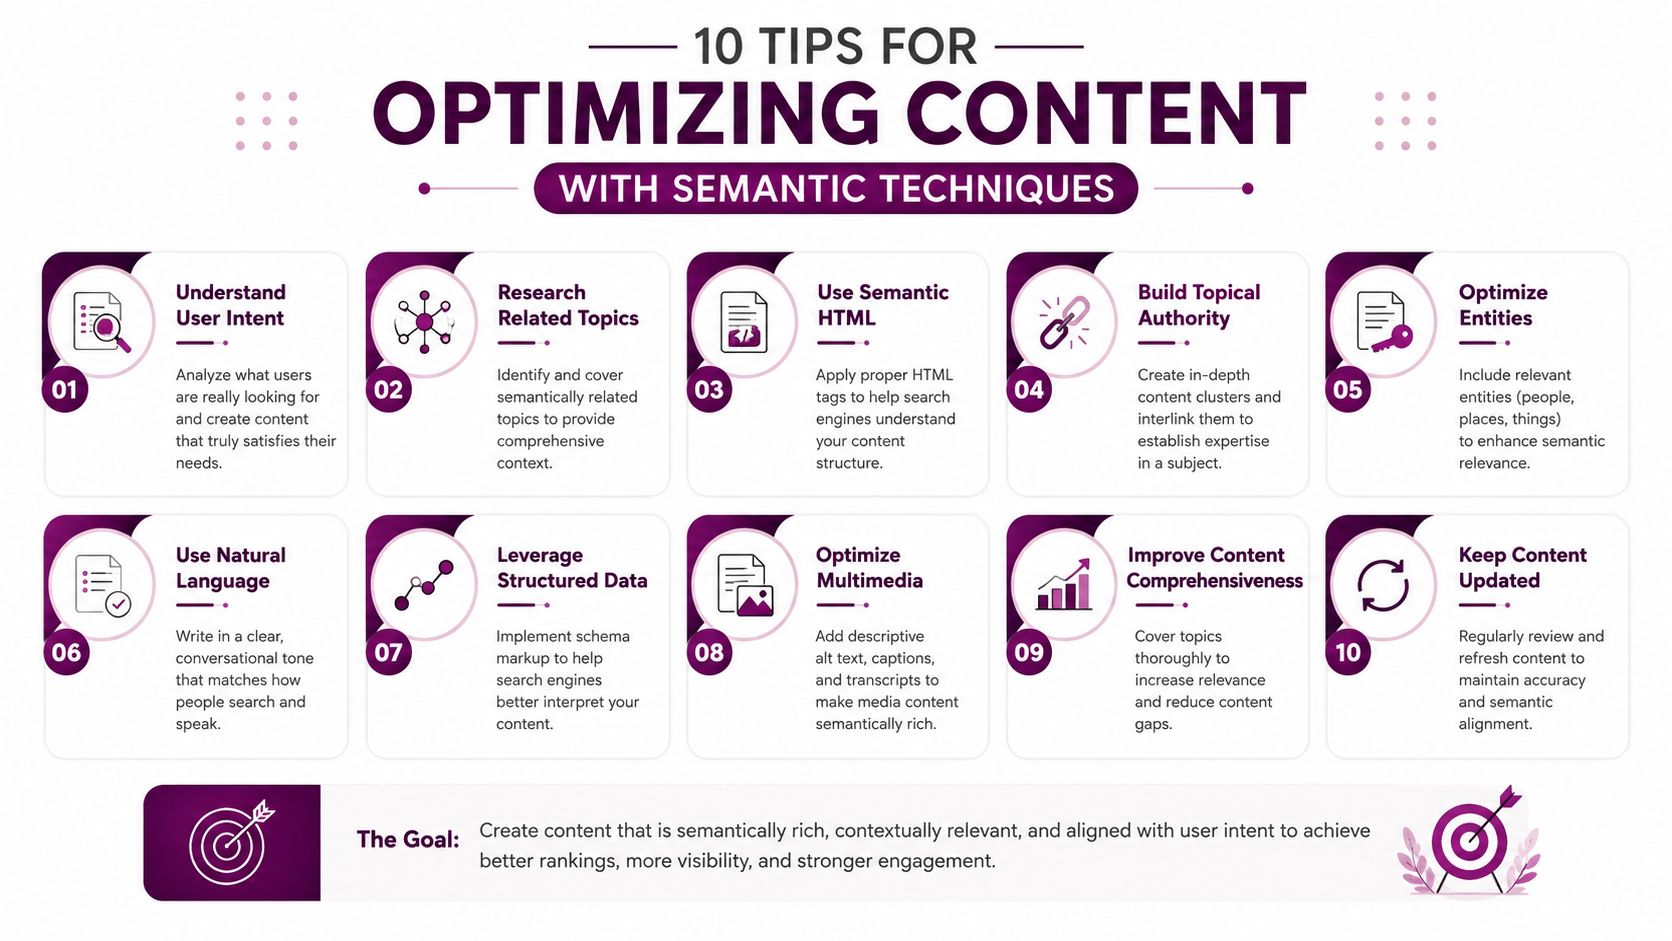
Inizia con una pagina che risponde a un intento principale, quindi mappa le entità correlate che appartengono naturalmente ad essa. Una pagina prodotto sulle scarpe da corsa non dovrebbe solo ripetere l'espressione “scarpe da corsa”, dovrebbe coprire calzata, ammortizzazione, andatura, terreno e casi d'uso dove pertinente. Quel tipo di copertura semantica segnala completezza tematica senza sembrare forzata.
Test utile: se un termine sembrerebbe strano in un glossario accanto all'argomento della pagina, lascialo fuori.
Una seconda tattica è usare i titoli come segnali semantici. Gli H2 e H3 dovrebbero riflettere i principali rami concettuali dell'argomento, non solo varianti di keyword. Questo aiuta i lettori a scansionare la pagina e aiuta i sistemi di ricerca a comprendere la logica interna della pagina.
Usa il confronto, non la ripetizione
Le pagine semantiche più efficaci spesso si leggono come confronti attenti. Distinguono idee correlate, chiariscono casi limite e rispondono alle domande che i lettori probabilmente porranno dopo. È meglio che ripetere una frase in forme leggermente diverse.
Un flusso di lavoro semplice funziona bene sulle pagine esistenti:
- Leggi la pagina come un nuovo arrivato. Segna le sezioni che ripetono la stessa idea senza aggiungere contesto.
- Controlla le pagine concorrenti. Nota quali sotto-argomenti coprono che la tua pagina tralascia.
- Aggiungi le entità mancanti naturalmente. Usale in spiegazioni, esempi e sezioni di supporto.
- Taglia il linguaggio di riempimento. Mantieni la pagina focalizzata sul compito o sulla domanda principale.
- Rivedi la copertura semantica dopo la modifica. Un audit semantico dovrebbe mostrare che l'argomento è spiegato da diversi angoli, non imbottito di sinonimi.
Per i team che desiderano un flusso di lavoro strutturato per i contenuti, questa guida all'ottimizzazione dei contenuti è un punto di partenza utile.
Bilanciare ampiezza e moderazione
La ricerca fondamentale sulla LSI ha anche stabilito che le matrici termine-documento sono comunemente approssimate utilizzando circa 50–100 fattori ortogonali, il che dimostra che il metodo riguarda il bilanciamento della riduzione con le prestazioni, non la massimizzazione del volume documento di linguistica di Stanford. Quell'idea si traduce bene nella scrittura SEO. Una copertura ampia aiuta, ma solo quando ogni concetto aggiunto guadagna il suo posto.
Se vuoi una regola semplice, usa questa: aggiungi concetti che approfondiscono la risposta, non parole che la decorano semplicemente. L'ottimizzazione semantica funziona quando la pagina diventa più facile da classificare e più facile da fidarsi.
Conclusione e passi successivi
La Latent Semantic Indexing è nata come metodo di recupero delle informazioni basato su SVD, pattern di co-occorrenza nascosti e approssimazione a basso rango. Non è una tattica di stuffing di sinonimi e non è una leva SEO magica. È una base utile per comprendere perché il significato, il contesto e la struttura dell'argomento contano così tanto nella ricerca.
Quella storia porta a una conclusione pratica. I motori moderni utilizzano sistemi semantici molto più avanzati, ma la lezione principale rimane invariata: le pagine vincono quando coprono chiaramente un argomento e lo supportano con concetti correlati che hanno senso per gli esseri umani. Se il tuo team ha trattato le “keyword LSI” come una formula, smetti di farlo e inizia invece a controllare i contenuti per la completezza semantica.
Scegli una pagina importante per il tuo business, rivedi la copertura dell'argomento e stringi la struttura attorno all'intento sottostante alla query. Quindi misura se la pagina si legge meglio, risponde in modo più completo e supporta uno scopo di ricerca più chiaro.
Una CTA per Keyword Kick.