Twój zespół ma wypełniony kalendarz treści, kolejny brief czeka na realizację, a ktoś właśnie rzucił w wątku na Slacku hasło „słowa kluczowe LSI”, jakby to był skrót do wyższych pozycji w wyszukiwarce. Problem w tym, że wielu specjalistów od optymalizacji treści goni za tym terminem, nie rozumiejąc stojącej za nim metody. W efekcie dodają dziwne synonimy, nienaturalnie powtarzają frazy i nazywają to optymalizacją. Latent Semantic Indexing (LSI) jest starsze, bardziej techniczne i znacznie ciekawsze niż takie podejście.
Czym jest latent semantic indexing to pytanie o to, jak maszyny mogą rozumieć znaczenie na podstawie wzorców w języku, a nie tylko poprzez dopasowanie dokładnych słów. To rozróżnienie ma kluczowe znaczenie, ponieważ oddziela prawdziwą teorię wyszukiwania informacji od marketingowego mitu, jakoby LSI było taktyką upychania słów kluczowych. Jeśli kiedykolwiek musiałeś tłumaczyć autorom, dlaczego „po prostu dodaj więcej powiązanych słów” nie jest strategią, ten przewodnik jest dla Ciebie.
Wprowadzenie do indeksowania semantycznego
Zespoły ds. treści często zauważają ten sam schemat: strona słabo rankuje, ktoś analizuje konkurencję i w zespole zapada decyzja, że odpowiedzią muszą być „dodatkowe słowa kluczowe LSI”. Powstaje szkic wypełniony luźno powiązanymi frazami, ale tekst brzmi sztucznie, a strona nadal nie rozwiązuje problemu czytelnika.
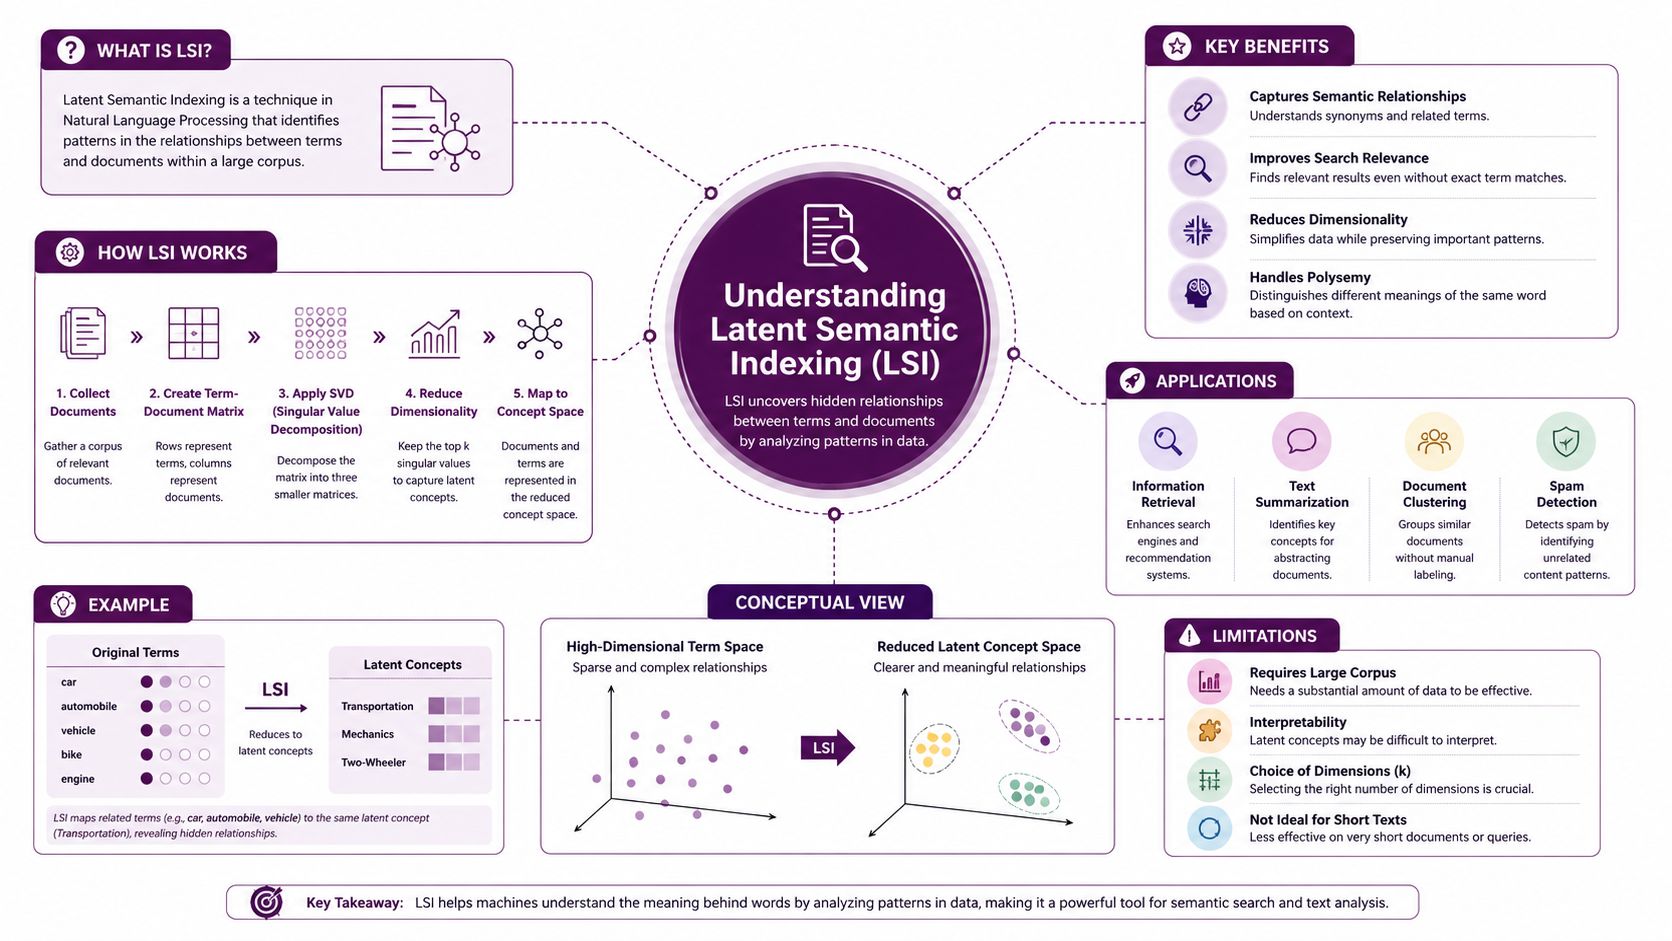
Ta frustracja zazwyczaj wynika z nieporozumienia. Latent Semantic Indexing wprowadzono jako sposób na redukcję niedopasowania leksykalnego w wyszukiwaniu informacji, wykorzystując statystycznie wywiedzione indeksy pojęć zamiast dopasowywania pojedynczych słów. Odbywa się to poprzez rozkład SVD (Singular Value Decomposition) na macierzy term-dokument artykuł o LSI. W ujęciu akademickim chodzi o odkrywanie ukrytych wzorców w całym korpusie tekstów, a nie o posypywanie wpisu na blogu synonimami.
Dla marketerów to najważniejszy wniosek. Wartość LSI nie tkwi w magicznej sztuczce rankingowej, lecz w idei, że znaczenie można wywnioskować z kontekstu, współwystępowania słów i struktury tematycznej. To zmiana myślenia, której zespoły potrzebują, aby skutecznie prowadzić semantyczne SEO.
Zrozumienie Latent Semantic Indexing
Jak działa ta metoda
Wyobraź sobie macierz term-dokument jako ogromny arkusz kalkulacyjny. Wiersze to słowa, kolumny to dokumenty, a liczby pokazują, gdzie terminy występują razem. LSI stosuje rozkład według wartości osobliwych (SVD) do tej macierzy i kompresuje ją do przestrzeni semantycznej o niższym wymiarze, zazwyczaj około 100–300 ortogonalnych czynników ukrytych TREC.
Ta redukcja jest istotna, ponieważ nie tylko zmniejsza ilość danych, ale ujawnia strukturę. Zapytanie i dokument mogą znaleźć się blisko siebie w przestrzeni ukrytej, nawet jeśli nie dzielą tych samych słów powierzchniowych – dlatego LSI pomaga w radzeniu sobie z synonimami i niedopasowaniem słownictwa. Podręcznik Stanforda dotyczący wyszukiwania informacji (IR) opisuje to jako aproksymację niskiego rzędu macierzy term-dokument, która utrzymuje wysoką trafność nawet przy niskim nakładaniu się dokładnych terminów podręcznik Stanford IR.
Praktyczna zasada: jeśli dwie strony używają różnych sformułowań, ale odpowiadają na ten sam zamiar, podobieństwo semantyczne może sprawić, że będą ze sobą powiązane.
Dlaczego ma to znaczenie dla trafności
Najprostszym sposobem na zrozumienie LSI jest porównanie go do latarki w ciemnym pokoju. Dopasowywanie surowych terminów oświetla tylko słowa, które widzisz bezpośrednio. LSI próbuje ujawnić kształt samego pokoju, ukryte relacje, które łączą te słowa w wielu dokumentach.
Dlatego metoda ta stała się wpływowa w badaniach nad wyszukiwaniem. Zapytanie o jeden termin może pasować do dokumentu, który używa innego terminu, o ile oba uczestniczą w podobnych wzorcach współwystępowania w korpusie artykuł MSU. Jeśli potrzebujesz praktycznej taksonomii do grupowania relacji tematycznych w nowoczesnym planowaniu treści, przydatnym towarzyszem będzie ten słowniczek klastrów tematycznych.
Głównym zamieszaniem dla wielu zespołów jest myślenie, że metoda dotyczy samych słów kluczowych. Tak nie jest. Chodzi o statystyczną geometrię języka i dlatego stała się ona fundamentalną ideą w systemach wyszukiwania na długo przed tym, jak ludzie zajmujący się SEO zaczęli o niej mówić.
Historia i relacja z LSA
Skąd wzięło się LSI
LSI pojawiło się w dziedzinie dzięki artykułowi z 1990 roku autorstwa Deerwestera i współpracowników, gdzie celem było zastąpienie dopasowywania pojedynczych słów indeksami pojęć przy użyciu SVD artykuł o LSI. To pochodzenie jest ważne, ponieważ pokazuje, że metoda została zaprojektowana do problemów wyszukiwania i klastrowania, a nie do tekstów marketingowych.
Akademickie ramy ułatwiają również zrozumienie zamieszania w nazewnictwie. W praktyce ludzie czasami zacierają różnice między LSI a LSA, ale źródła w tym briefie opisują tę samą linię z perspektywy wyszukiwania informacji, skupioną na aproksymacji macierzy, ukrytym współwystępowaniu i strukturze pojęć. Materiały Stanforda podkreślają widok macierzy niskiego rzędu, podczas gdy inne notatki z wykładów przedstawiają to samo podejście jako technikę redukcji rangi opartą na twierdzeniu Eckarta-Younga artykuł językoznawczy Stanforda.
Dlaczego historia jest nadal ważna
To tło jest istotne, ponieważ zapobiega częstemu błędowi w SEO. Kiedy ktoś mówi „słowa kluczowe LSI”, zazwyczaj używa luźnej etykiety marketingowej, a nie oryginalnej metody akademickiej. Główne źródła akademickie opisują LSI jako klasyczną technikę wyszukiwania opartą na SVD, a nie taktykę upychania słów kluczowych podręcznik Stanford IR.
Ta różnica to coś więcej niż akademickie czepialstwo. Pomaga zespołom przestać traktować głębię semantyczną jak listę kontrolną synonimów i zacząć myśleć jak architekci informacji. Jeśli potrzebujesz przyjaznego dla praktyków przeglądu tego, jak to nieporozumienie pojawia się w procesach SEO, ten przewodnik po LSI dla menedżerów SEO jest przydatnym punktem odniesienia.
Najprostszym sposobem na zapamiętanie historii jest to: LSI zaczęło się jako matematyczne rozwiązanie szumu w wyszukiwaniu, a nie jako hack content marketingowy. Gdy to stanie się jasne, reszta rozmowy o SEO stanie się znacznie łatwiejsza do oceny.
Obalanie mitów o słowach kluczowych LSI
Mity, które zespoły wciąż powtarzają
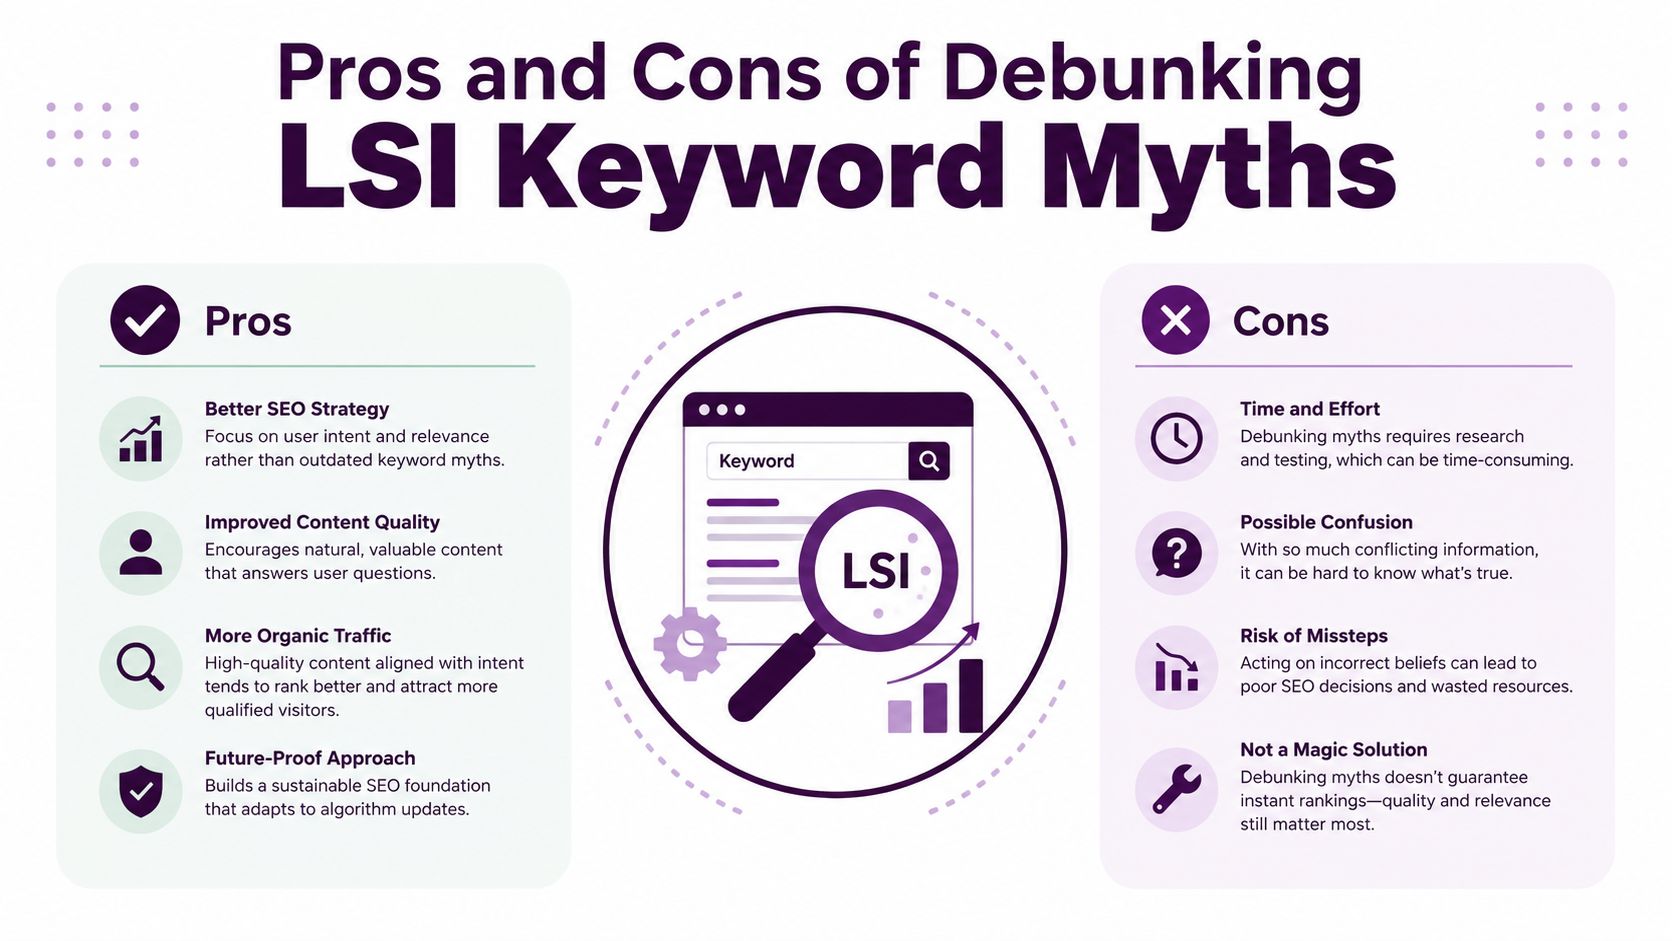
Pierwszym mitem jest to, że słowa kluczowe LSI to formalna lista fraz, które można wyodrębnić i wstawić, aby uzyskać lepsze pozycje. Takie podejście sprowadza metodę akademicką do chwytu marketingowego, przed czym ostrzega podręcznik Stanforda, traktując LSI jako aproksymację macierzy niskiego rzędu dla potrzeb wyszukiwania, a nie formułę na słowa kluczowe podręcznik Stanford IR.
Drugim mitem jest to, że dodawanie większej liczby powiązanych terminów automatycznie wzmacnia stronę. W rzeczywistości wymuszone listy synonimów często osłabiają przejrzystość, co jest przeciwieństwem tego, co chce osiągnąć wyszukiwanie semantyczne. LSI polega na wychwytywaniu relacji w korpusie, a nie na sprawianiu, by każdy akapit brzmiał sztucznie szeroko.
Trzecim mitem jest to, że sam termin wciąż opisuje działający mechanizm rankingowy SEO. Dlatego wiele artykułów nazywa to nowoczesną taktyką, podczas gdy główne źródła akademickie przedstawiają ją jako klasyczną metodę IR zbudowaną na SVD podręcznik Stanford IR. Jeśli chcesz porównać to błędne przekonanie z szerszym językiem SEO, dyskusja o pozycjonowaniu treści w odpowiedziach AI z MyMentions pokazuje, dlaczego pokrycie semantyczne jest ważniejsze niż przestarzałe etykiety słów kluczowych.
Czego przestać robić
- Przestań tworzyć zbiory synonimów. Jeśli sformułowanie nie pomaga czytelnikowi zrozumieć tematu, jest tylko wypełniaczem.
- Przestań traktować gęstość słów jako wyznacznik głębi. Trafność semantyczna wynika z pokrycia tematu, struktury i dopasowania do intencji.
- Przestań zakładać, że „powiązane terminy” oznaczają losowe wariacje. Dobre pisanie semantyczne wykorzystuje encje i pojęcia, które są integralne dla tematu.
Strona może zawierać więcej terminów, a mimo to być mniej użyteczna, jeśli tekst traci skupienie.
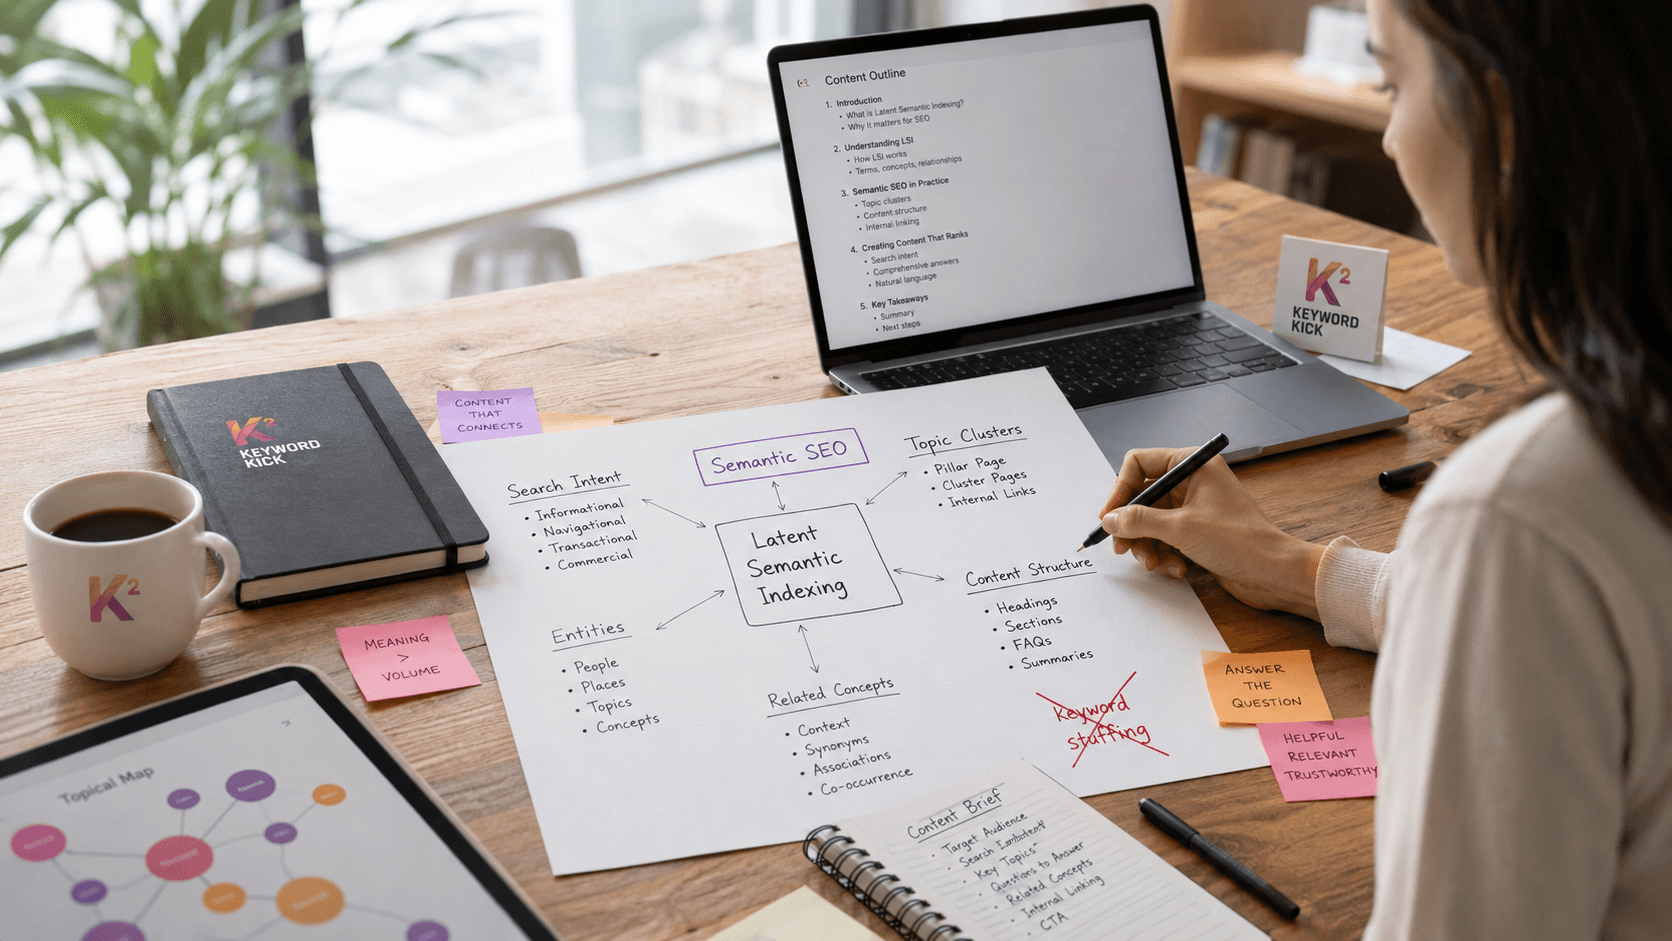
Lepszym modelem jest używanie LSI jako soczewki, a nie listy kontrolnej. Soczewka mówi ci, że znaczenie jest kontekstowe, ale nie usprawiedliwia niechlujnego tekstu. Semantyczne SEO działa, gdy strona jasno odpowiada na zapytanie, a następnie wzmacnia tę odpowiedź wspierającymi pojęciami, które pasują w sposób naturalny.
Jak wyszukiwarki interpretują semantykę
Od macierzy do znaczenia
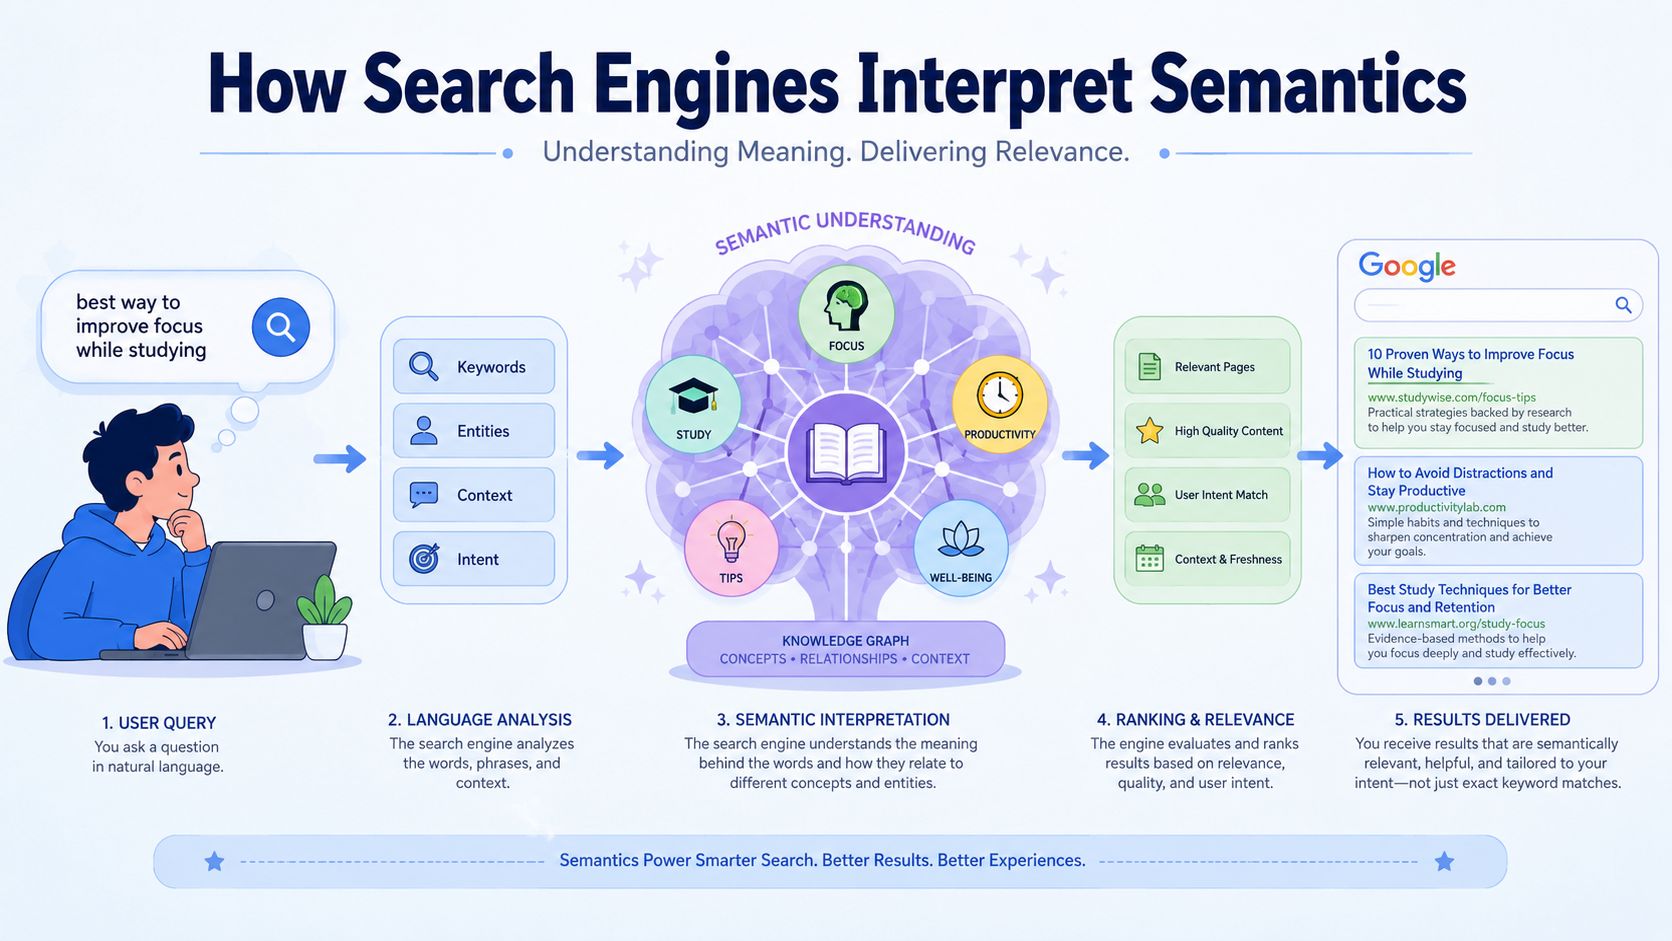
Nowoczesne wyszukiwarki nie polegają na oryginalnym algorytmie LSI, ale dążą do tego samego szerokiego celu: zrozumienia znaczenia wykraczającego poza dokładne nakładanie się słów. Historyczny model LSI używał SVD na macierzy term-dokument, aby wywnioskować ukrytą strukturę TREC. Dzisiejsze systemy wyszukiwania używają znacznie bardziej zaawansowanych metod semantycznych, ale zasada jest znajoma: kontekst ma znaczenie.
Ta zmiana jest powodem, dla którego zapytanie może zostać zinterpretowane poprawnie, nawet jeśli strona nie powtarza go słowo w słowo. Wyszukiwarki używają teraz sygnałów kontekstowych, rozpoznawania encji i reprezentacji wektorowych, aby zdecydować, czy wynik pasuje do intencji użytkownika. Stare podejście faktoryzacji macierzy jest użytecznym modelem myślowym, ale nie jest aktywną warstwą rankingową.
Dlaczego kontekst wygrywa z dokładnym dopasowaniem
Marketerzy często przesadzają. Słyszą, że wyszukiwarki „rozumieją semantykę” i zakładają, że każda strona potrzebuje stosu powiązanych słów. Pomaga pisanie, które jasno określa temat, podtemat i intencję, dzięki czemu wyszukiwarka może umieścić stronę w odpowiednim sąsiedztwie pojęciowym.
Dlatego tak ważne jest linkowanie wewnętrzne i organizacja tematyczna. Jeśli strona konsekwentnie wzmacnia pojęcie w nagłówkach, treści i powiązanych stronach, daje systemom wyszukiwania silniejsze dowody na to, czemu strona służy. Praktyczne spojrzenie na to, jak nowoczesne systemy interpretują i wykorzystują sygnały tematyczne, znajdziesz w słowniczku RankBrain, który stanowi pomost między klasycznymi ideami IR a nowoczesnym zachowaniem rankingowym.
Jak myśleć o wyszukiwaniu w erze AI
Wyszukiwanie jest teraz bardziej konwersacyjne i bardziej wrażliwe na kontekst niż systemy, które uczyniły LSI sławnym. To nie czyni LSI przestarzałym jako koncepcja, czyni je historycznie ważnym. Dało marketerom jedno z pierwszych czystych wyjaśnień, dlaczego myślenie o dokładnym dopasowaniu zawodzi, gdy język jest nieuporządkowany.
Jeśli optymalizujesz pod kątem odpowiedzi AI lub bogatych doświadczeń w wyszukiwaniu, sposób myślenia pozostaje ten sam. Pokryj temat precyzyjnie, używaj terminów, które należą do tego samego pola pojęciowego i unikaj wymuszania słów tylko dlatego, że brzmią blisko. Aby głębiej przyjrzeć się tej zmianie w praktycznych środowiskach SERP, zobacz pozycjonowanie treści w odpowiedziach AI od MyMentions.
Optymalizacja treści za pomocą technik semantycznych
Buduj wokół struktury tematycznej
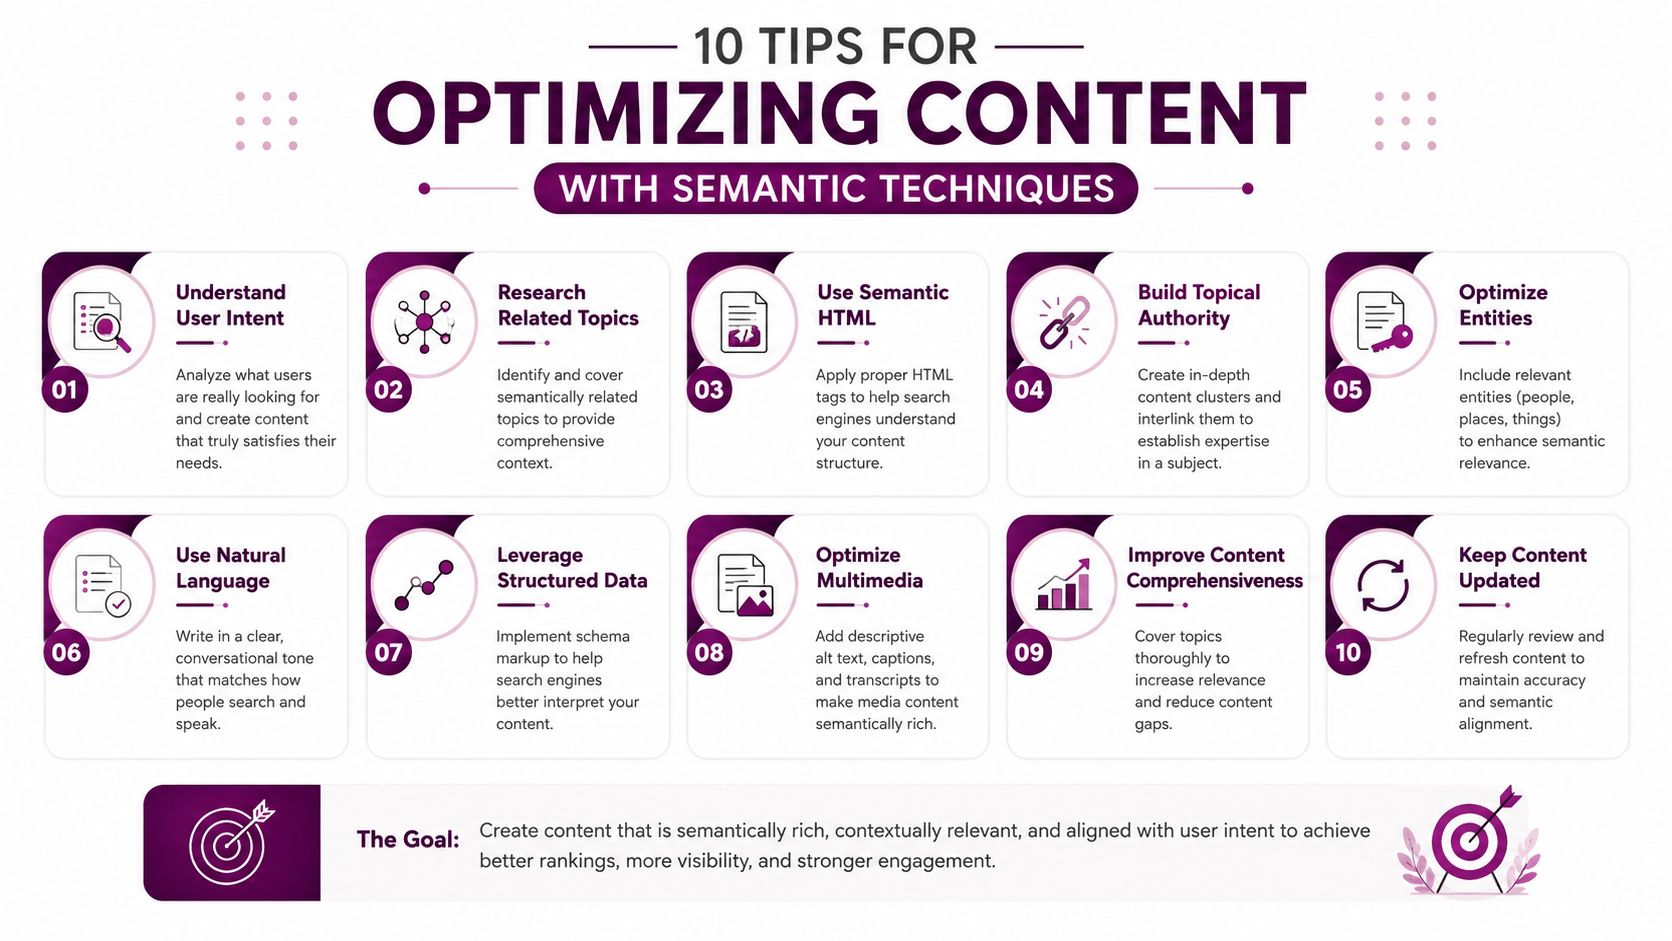
Zacznij od strony, która odpowiada na jedną główną intencję, a następnie zmapuj powiązane encje, które naturalnie do niej należą. Strona produktowa o butach do biegania nie powinna tylko powtarzać frazy „buty do biegania”, powinna obejmować dopasowanie, amortyzację, chód, teren i zastosowanie, gdzie to istotne. Tego rodzaju pokrycie semantyczne sygnalizuje kompletność tematyczną bez brzmienia wymuszonego.
Użyteczny test: jeśli termin wyglądałby dziwnie w słowniczku obok tematu strony, pomiń go.
Drugą taktyką jest używanie nagłówków jako drogowskazów semantycznych. H2 i H3 powinny odzwierciedlać główne gałęzie pojęciowe tematu, a nie tylko warianty słów kluczowych. Pomaga to czytelnikom skanować stronę, a systemom wyszukiwania zrozumieć jej wewnętrzną logikę.
Używaj porównań, nie powtórzeń
Najskuteczniejsze strony semantyczne często czyta się jak staranne porównania. Rozróżniają powiązane idee, wyjaśniają przypadki brzegowe i odpowiadają na pytania, które czytelnicy prawdopodobnie zadadzą w następnej kolejności. To lepsze niż powtarzanie jednej frazy w nieco innych formach.
Prosty proces pracy sprawdza się na istniejących stronach:
- Przeczytaj stronę jako nowicjusz. Zaznacz sekcje, które powtarzają tę samą ideę bez dodawania kontekstu.
- Sprawdź strony konkurencji. Zwróć uwagę, jakie podtematy poruszają, których brakuje na Twojej stronie.
- Dodaj brakujące encje w naturalny sposób. Używaj ich w wyjaśnieniach, przykładach i sekcjach wspierających.
- Przytnij język wypełniający. Utrzymuj stronę skupioną na głównym zadaniu lub pytaniu.
- Przejrzyj pokrycie semantyczne po edycji. Audyt semantyczny powinien pokazać, że temat jest wyjaśniony z kilku perspektyw, a nie wypełniony synonimami.
Dla zespołów, które chcą ustrukturyzowanego procesu pracy nad treścią, ten przewodnik po optymalizacji treści jest użytecznym punktem wyjścia.
Równoważ szerokość z powściągliwością
Podstawowe badania nad LSI ustaliły również, że macierze term-dokument są powszechnie aproksymowane przy użyciu około 50–100 czynników ortogonalnych, co pokazuje, że metoda polega na równoważeniu redukcji z wydajnością, a nie na maksymalizacji objętości artykuł językoznawczy Stanforda. Ta idea dobrze przekłada się na pisanie SEO. Szerokie pokrycie pomaga, ale tylko wtedy, gdy każde dodane pojęcie zasługuje na swoje miejsce.
Jeśli chcesz prostą zasadę, użyj tej: dodawaj pojęcia, które pogłębiają odpowiedź, a nie słowa, które jedynie ją dekorują. Optymalizacja semantyczna działa, gdy strona staje się łatwiejsza do sklasyfikowania i łatwiejsza do zaufania.
Podsumowanie i kolejne kroki
Latent Semantic Indexing zaczęło się jako metoda wyszukiwania informacji zbudowana na SVD, ukrytych wzorcach współwystępowania i aproksymacji niskiego rzędu. To nie jest taktyka upychania synonimów i nie jest to magiczna dźwignia SEO. To użyteczny fundament do zrozumienia, dlaczego znaczenie, kontekst i struktura tematyczna mają tak duże znaczenie w wyszukiwaniu.
Ta historia prowadzi do praktycznego wniosku. Nowoczesne wyszukiwarki używają znacznie bardziej zaawansowanych systemów semantycznych, ale główna lekcja pozostaje niezmieniona: strony wygrywają, gdy jasno pokrywają temat i wspierają go powiązanymi pojęciami, które mają sens dla ludzi. Jeśli Twój zespół traktował „słowa kluczowe LSI” jak formułę, przestań to robić i zacznij audytować treści pod kątem kompletności semantycznej.
Wybierz jedną stronę, która jest ważna dla Twojego biznesu, przejrzyj pokrycie tematu i zacieśnij strukturę wokół podstawowej intencji stojącej za zapytaniem. Następnie zmierz, czy strona czyta się lepiej, odpowiada pełniej i wspiera jaśniejszy cel wyszukiwania.
CTA dla Keyword Kick.