Der Content-Kalender Ihres Teams ist voll, das nächste Briefing steht an und jemand hat gerade „LSI-Keywords“ in den Slack-Channel geworfen, als wäre es eine Abkürzung zu besseren Rankings. Das Problem: Viele Content-Optimierer jagen dem Begriff hinterher, ohne die Methode dahinter zu verstehen. Das Ergebnis sind holprige Synonyme, unnatürliche Wortwiederholungen und das, was sie dann „Optimierung“ nennen. Latent Semantic Indexing ist älter, technischer und weitaus interessanter als das.
Die Frage „Was ist Latent Semantic Indexing?“ dreht sich darum, wie Maschinen Bedeutung aus Sprachmustern verstehen, statt nur exakte Wortübereinstimmungen zu prüfen. Dieser Unterschied ist entscheidend, denn er trennt die echte Information-Retrieval-Theorie von dem Marketing-Mythos, LSI sei eine Taktik für Keyword-Stuffing. Wenn Sie Ihren Autoren schon einmal erklären mussten, warum „einfach mehr verwandte Wörter hinzufügen“ keine Strategie ist, dann ist dieser Leitfaden für Sie.
Einführung in das semantische Indexieren
Content-Teams bemerken oft dasselbe Muster: Eine Seite rankt schlecht, jemand prüft die Konkurrenzseiten und das Team beschließt, die Lösung müsse „mehr LSI-Keywords“ sein. Der Entwurf kommt zurück, vollgestopft mit lose zusammenhängenden Begriffen, doch der Text wirkt unnatürlich und die Seite löst das Problem des Lesers immer noch nicht.
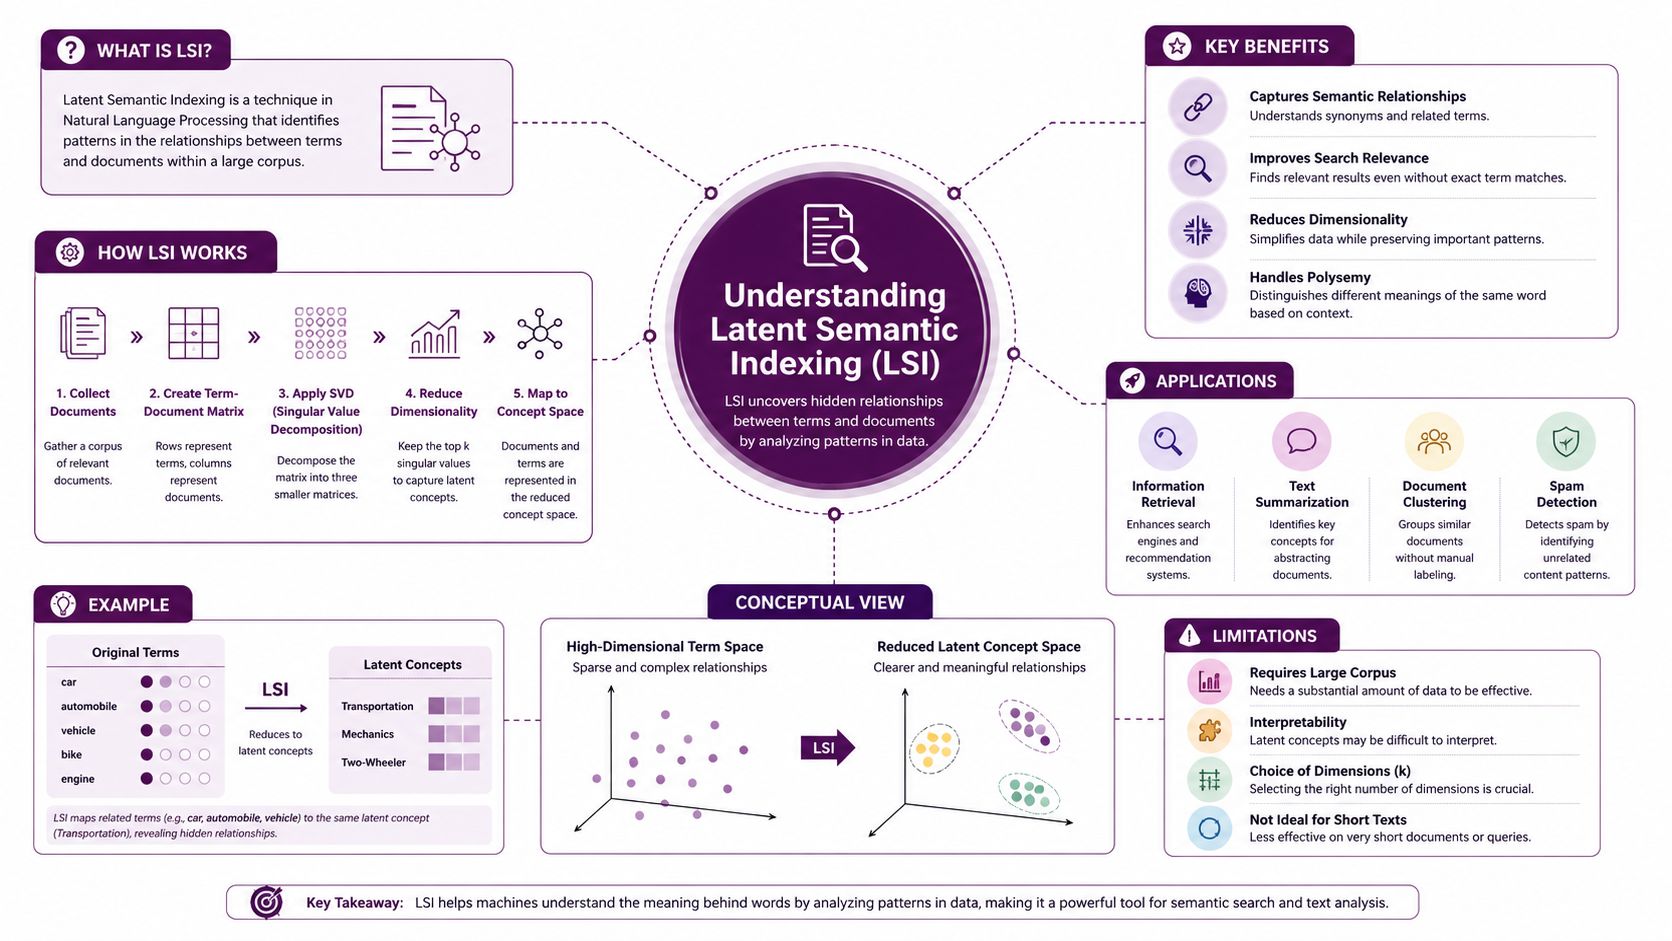
Diese Frustration beginnt meist mit einem Missverständnis. Latent Semantic Indexing wurde eingeführt, um lexikalische Diskrepanzen (lexical mismatch) beim Information Retrieval zu reduzieren. Dabei werden statistisch abgeleitete Konzept-Indizes anstelle von Einzelwort-Abgleichen verwendet – und das geschieht durch trunkiertes SVD (Singular Value Decomposition) auf einer Term-Dokument-Matrix LSI-Paper. Akademisch ausgedrückt geht es darum, verborgene Muster in einem gesamten Korpus aufzudecken, nicht darum, Synonyme in einen Blogbeitrag zu streuen.
Für Marketer ist das die wichtigste Erkenntnis. Der Wert von LSI liegt nicht in einem magischen Ranking-Trick, sondern in der Idee, dass Bedeutung aus Kontext, Ko-Vorkommen und Themenstruktur abgeleitet werden kann. Das ist der Mindset-Wandel, den Teams brauchen, bevor sie semantisches SEO erfolgreich umsetzen können.
Latent Semantic Indexing verstehen
Wie die Methode funktioniert
Stellen Sie sich eine Term-Dokument-Matrix wie eine riesige Tabelle vor. Zeilen sind Wörter, Spalten sind Dokumente und die Zahlen zeigen, wo Begriffe gemeinsam auftreten. LSI wendet die Singularwertzerlegung (SVD) auf diese Matrix an und komprimiert sie in einen niederdimensionalen semantischen Raum, typischerweise etwa 100–300 orthogonale latente Faktoren TREC.
Diese Reduktion ist wichtig, weil sie nicht nur Daten schrumpft, sondern Strukturen offenlegt. Eine Suchanfrage und ein Dokument können im latenten Raum nah beieinander liegen, selbst wenn sie keine gemeinsamen Wörter auf der Oberfläche haben. Deshalb hilft LSI bei Synonymen und Vokabular-Diskrepanzen. Das Stanford-Lehrbuch für Information Retrieval beschreibt dies als Low-Rank-Approximation der Term-Dokument-Matrix, die die Ähnlichkeit hoch hält, auch wenn die exakte Wortüberschneidung gering ist Stanford IR-Buch.
Praktische Regel: Wenn zwei Seiten unterschiedliche Formulierungen verwenden, aber dieselbe Suchintention bedienen, kann semantische Ähnlichkeit sie dennoch als verwandt einstufen.
Warum das für die Relevanz wichtig ist
Der einfachste Weg, LSI zu verstehen, ist der Vergleich mit einer Taschenlampe in einem dunklen Raum. Roher Wortabgleich beleuchtet nur die Wörter, die man direkt sieht. LSI versucht, die Form des Raumes selbst zu enthüllen – die verborgenen Beziehungen, die diese Wörter über viele Dokumente hinweg verbinden.
Deshalb wurde die Methode in der Retrieval-Forschung so einflussreich. Eine Suchanfrage zu einem Begriff kann ein Dokument finden, das einen anderen Begriff verwendet, solange beide in ähnlichen Ko-Vorkommensmustern innerhalb des Korpus auftauchen MSU-Paper. Wenn Sie eine praktische Taxonomie zur Gruppierung dieser Themenbeziehungen in der modernen Content-Planung suchen, ist dieses Glossar zu Topic Clusters ein nützlicher Begleiter.
Die größte Verwirrung bei vielen Teams entsteht durch den Gedanken, die Methode drehe sich um die Keywords selbst. Das tut sie nicht. Es geht um die statistische Geometrie der Sprache – und genau deshalb war sie ein grundlegendes Konzept in Retrieval-Systemen, lange bevor SEOs darüber sprachen.
Geschichte und Beziehung zu LSA
Woher LSI stammt
LSI hielt Einzug in das Fachgebiet durch ein Paper aus dem Jahr 1990 von Deerwester und Kollegen, in dem das Ziel darin bestand, den Einzelwort-Abgleich durch Konzept-Indizes mittels trunkierter SVD zu ersetzen LSI-Paper. Dieser Ursprung ist wichtig, da er zeigt, dass die Methode für Retrieval- und Clustering-Probleme entwickelt wurde, nicht für Marketing-Texte.
Der akademische Rahmen macht auch die Namensverwirrung verständlicher. In der Praxis vermischen Leute manchmal LSI und LSA, aber die Quellen in diesem Briefing beschreiben dieselbe Abstammung aus der Perspektive des Information Retrieval, fokussiert auf Matrix-Approximation, verborgenes Ko-Vorkommen und Konzeptstruktur. Das Stanford-Material betont die Low-Rank-Matrix-Sicht, während andere Vorlesungsunterlagen denselben Ansatz als Rangreduktionstechnik beschreiben, die auf dem Eckart-Young-Theorem basiert Stanford Linguistik-Paper.
Warum die Geschichte heute noch relevant ist
Dieser Hintergrund ist wichtig, weil er einen häufigen SEO-Fehler verhindert. Wenn jemand von „LSI-Keywords“ spricht, verwendet er meist ein loses Marketing-Label, nicht die ursprüngliche akademische Methode. Zentrale akademische Quellen beschreiben LSI als klassische SVD-basierte Retrieval-Technik, nicht als Taktik für Keyword-Stuffing Stanford IR-Buch.
Dieser Unterschied ist mehr als akademische Haarspalterei. Er hilft Teams, semantische Tiefe nicht mehr wie eine Synonym-Checkliste zu behandeln, sondern wie Informationsarchitekten zu denken. Wenn Sie einen praxisnahen Überblick darüber benötigen, wie sich dieses Missverständnis in SEO-Workflows zeigt, ist dieser Leitfaden zu LSI für SEO-Manager ein nützlicher Referenzpunkt.
Die einfachste Art, sich die Geschichte zu merken: LSI begann als mathematische Lösung für Rauschen beim Information Retrieval, nicht als Content-Marketing-Hack. Sobald das klar ist, lässt sich der Rest der SEO-Diskussion viel leichter bewerten.
Mythen über LSI-Keywords entlarven
Die Mythen, die Teams ständig wiederholen
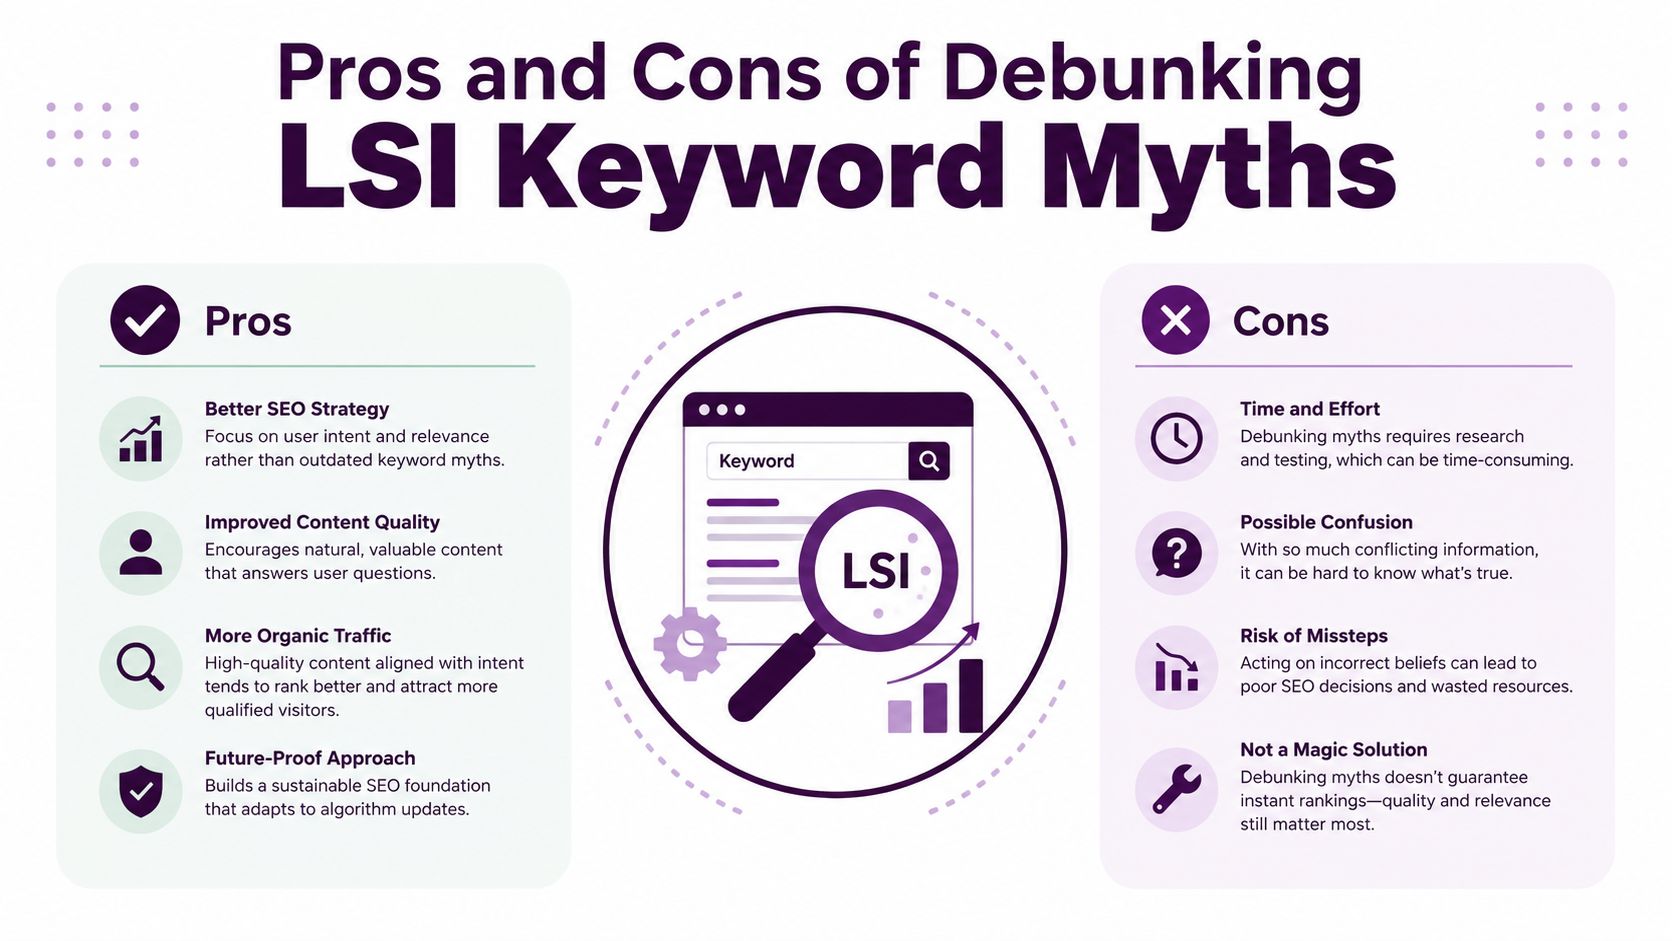
Der erste Mythos ist, dass LSI-Keywords eine formale Liste von Phrasen seien, die man extrahieren und einfügen kann, um bessere Rankings zu erzielen. Diese Sichtweise reduziert die akademische Methode auf einen Content-Gimmick – genau das, wovor das Stanford IR-Buch warnt, indem es LSI als Low-Rank-Matrix-Approximation für das Retrieval behandelt, nicht als Keyword-Formel Stanford IR-Buch.
Der zweite Mythos ist, dass das Hinzufügen von mehr verwandten Begriffen eine Seite automatisch stärker macht. In der Realität schwächen erzwungene Synonymlisten oft die Klarheit, was das Gegenteil dessen ist, was semantisches Retrieval erreichen will. Bei LSI geht es darum, Beziehungen in einem Korpus zu erfassen, nicht darum, jeden Absatz künstlich breit klingen zu lassen.
Der dritte Mythos ist, dass der Begriff selbst noch einen aktiven SEO-Ranking-Mechanismus beschreibt. Deshalb bezeichnen viele Artikel es als moderne Taktik, obwohl die zentralen akademischen Quellen es als klassische IR-Methode auf SVD-Basis einordnen Stanford IR-Buch. Wenn Sie diese Fehlvorstellung mit breiterer SEO-Sprache vergleichen möchten, zeigt die Diskussion über Ranking-Content in KI-Antworten von MyMentions, warum semantische Abdeckung wichtiger ist als veraltete Keyword-Labels.
Was Sie nicht mehr tun sollten
- Hören Sie auf, Synonym-Listen zu erstellen. Wenn die Formulierung dem Leser nicht hilft, das Thema zu verstehen, ist es nur Füllmaterial.
- Hören Sie auf, Dichte als Maß für Tiefe zu betrachten. Semantische Relevanz entsteht durch Abdeckung, Struktur und Ausrichtung auf die Intention.
- Hören Sie auf anzunehmen, „verwandte Begriffe“ bedeuteten zufällige Variationen. Gutes semantisches Schreiben nutzt Entitäten und Konzepte, die integraler Bestandteil des Themas sind.
Eine Seite kann mehr Begriffe enthalten und sich dennoch weniger nützlich anfühlen, wenn der Text den Fokus verliert.
Ein besseres Modell ist es, LSI als Linse zu verwenden, nicht als Checkliste. Die Linse sagt Ihnen, dass Bedeutung kontextabhängig ist, aber sie entschuldigt keine schlampigen Texte. Semantisches SEO funktioniert, wenn die Seite die Suchanfrage klar beantwortet und diese Antwort dann mit unterstützenden Konzepten verstärkt, die natürlich passen.
Wie Suchmaschinen Semantik interpretieren
Von Matrizen zur Bedeutung
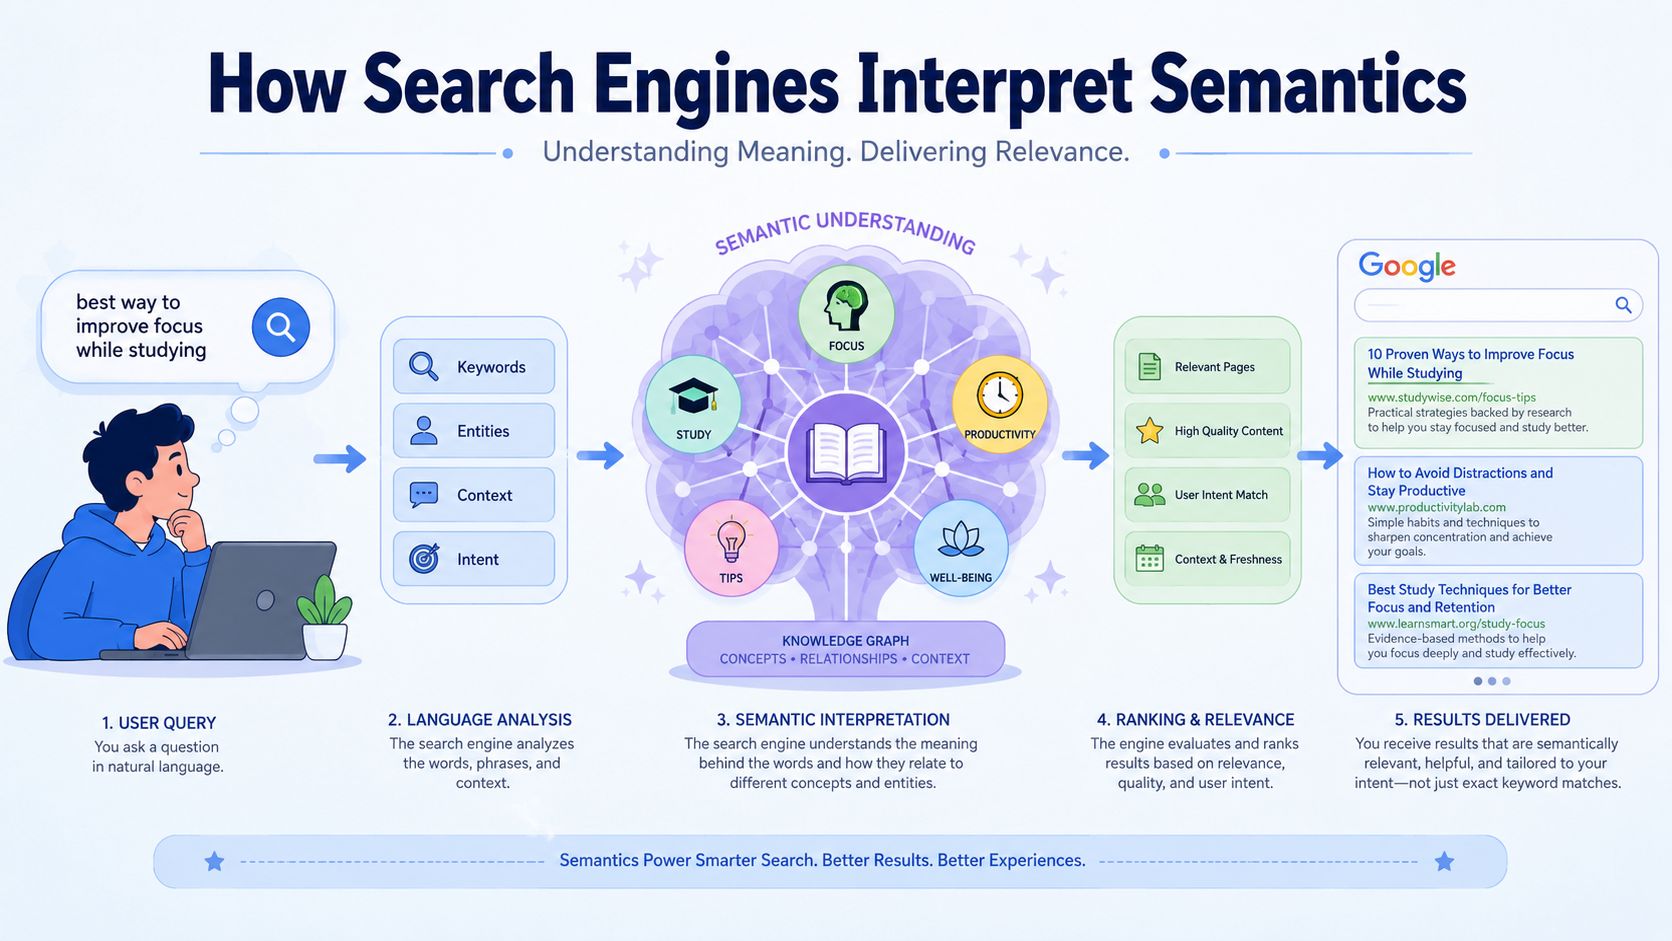
Moderne Suchmaschinen verlassen sich nicht auf den ursprünglichen LSI-Algorithmus, verfolgen aber dasselbe Ziel: Bedeutung jenseits exakter Wortüberschneidungen zu verstehen. Das historische LSI-Modell nutzte SVD auf einer Term-Dokument-Matrix, um latente Strukturen abzuleiten TREC. Heutige Suchsysteme nutzen weitaus fortschrittlichere semantische Methoden, aber das Prinzip bleibt vertraut: Kontext ist entscheidend.
Dieser Wandel ist der Grund, warum eine Suchanfrage korrekt interpretiert werden kann, selbst wenn die Seite sie nicht Wort für Wort wiederholt. Suchmaschinen nutzen heute Kontextsignale, Entitätenerkennung und vektorbasierte Repräsentationen, um zu entscheiden, ob ein Ergebnis zur Nutzerintention passt. Der alte Ansatz der Matrixfaktorisierung ist ein nützliches mentales Modell, aber nicht die aktuelle Ranking-Ebene.
Warum Kontext exaktes Matching schlägt
Marketer überkorrigieren oft. Sie hören, dass Suchmaschinen „Semantik verstehen“ und nehmen an, jede Seite brauche einen Haufen verwandter Wörter. Was wirklich hilft, ist ein Text, der Thema, Unterthema und Intention klar etabliert, damit die Suchmaschine die Seite in die richtige konzeptionelle Nachbarschaft einordnen kann.
Deshalb sind interne Verlinkungen und thematische Organisation so wichtig. Wenn eine Seite ein Konzept konsistent über Überschriften, Fließtext und verwandte Seiten hinweg verstärkt, liefert sie Suchsystemen stärkere Beweise dafür, worum es auf der Seite geht. Für einen praktischen Blick darauf, wie moderne Systeme thematische Signale interpretieren und wiederverwenden, ist der RankBrain-Glossareintrag eine hilfreiche Brücke zwischen klassischen IR-Ideen und modernem Ranking-Verhalten.
Wie man über die KI-Ära der Suche denkt
Die Suche ist heute konversationsorientierter und kontextsensitiver als die Systeme, die LSI berühmt gemacht haben. Das macht LSI als Konzept nicht obsolet, sondern historisch bedeutsam. Es gab Marketern eine der ersten klaren Erklärungen dafür, warum das Denken in exakten Übereinstimmungen bei komplexer Sprache scheitert.
Wenn Sie für KI-Antworten oder Rich-Search-Erlebnisse optimieren, bleibt das Mindset dasselbe: Decken Sie das Thema präzise ab, verwenden Sie Begriffe, die in dasselbe konzeptionelle Feld gehören, und vermeiden Sie es, Wörter zu erzwingen, nur weil sie thematisch benachbart klingen. Für einen tieferen Einblick in diesen Wandel in praktischen SERP-Umgebungen, siehe Ranking-Content in KI-Antworten von MyMentions.
Content mit semantischen Techniken optimieren
Auf Themenstruktur aufbauen
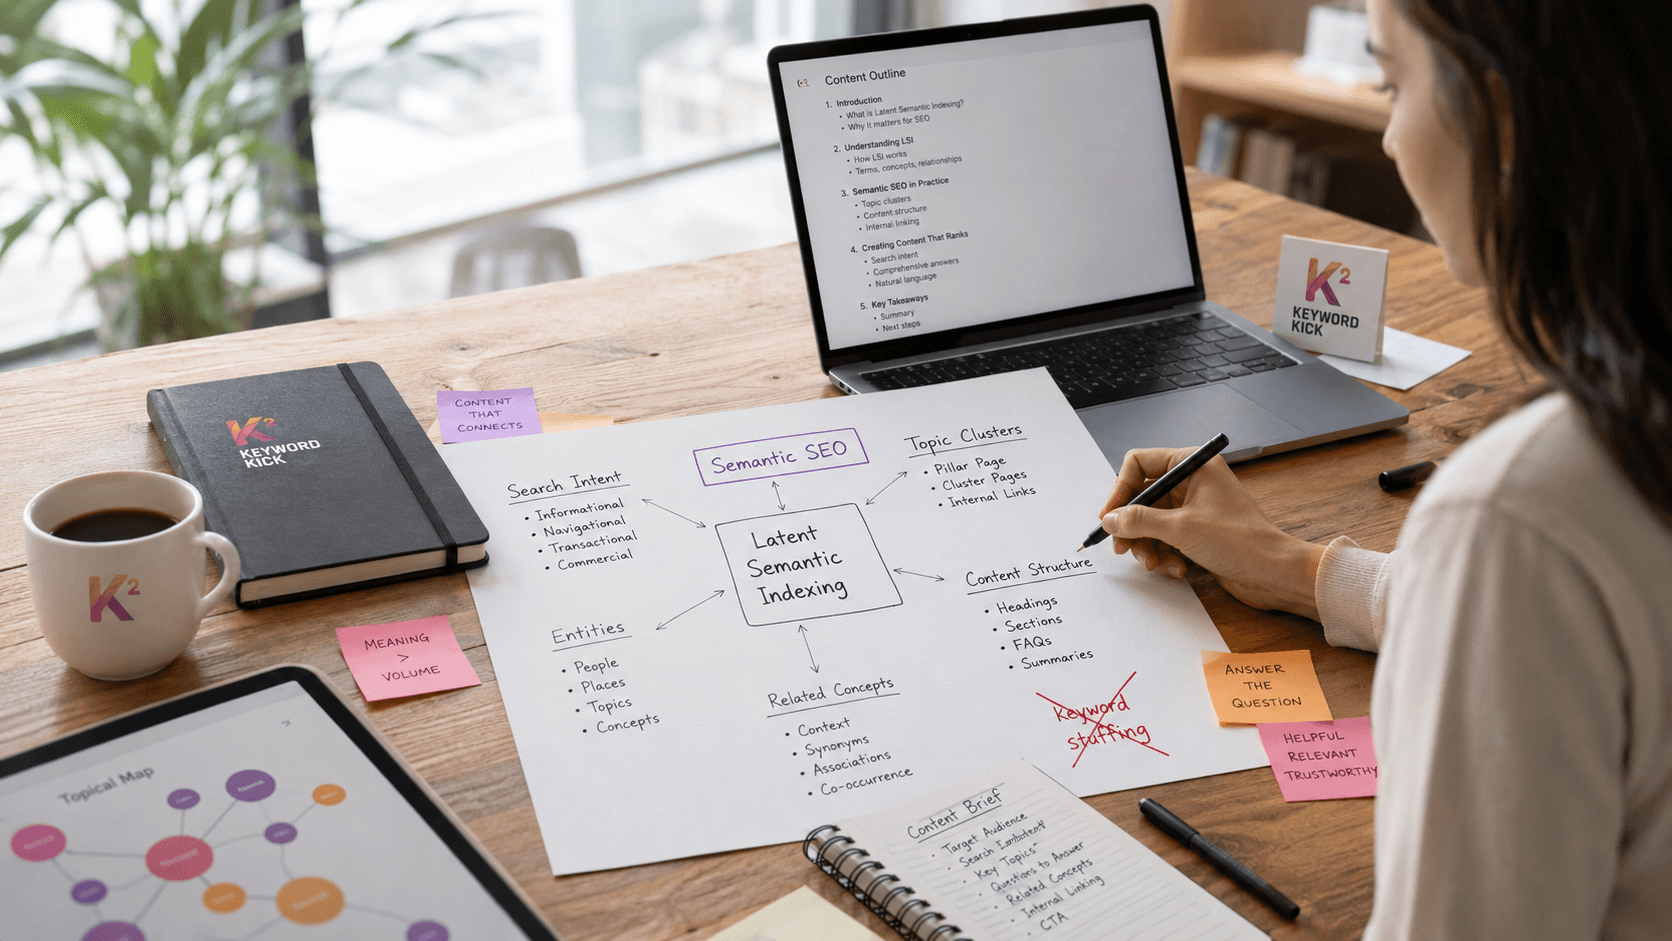
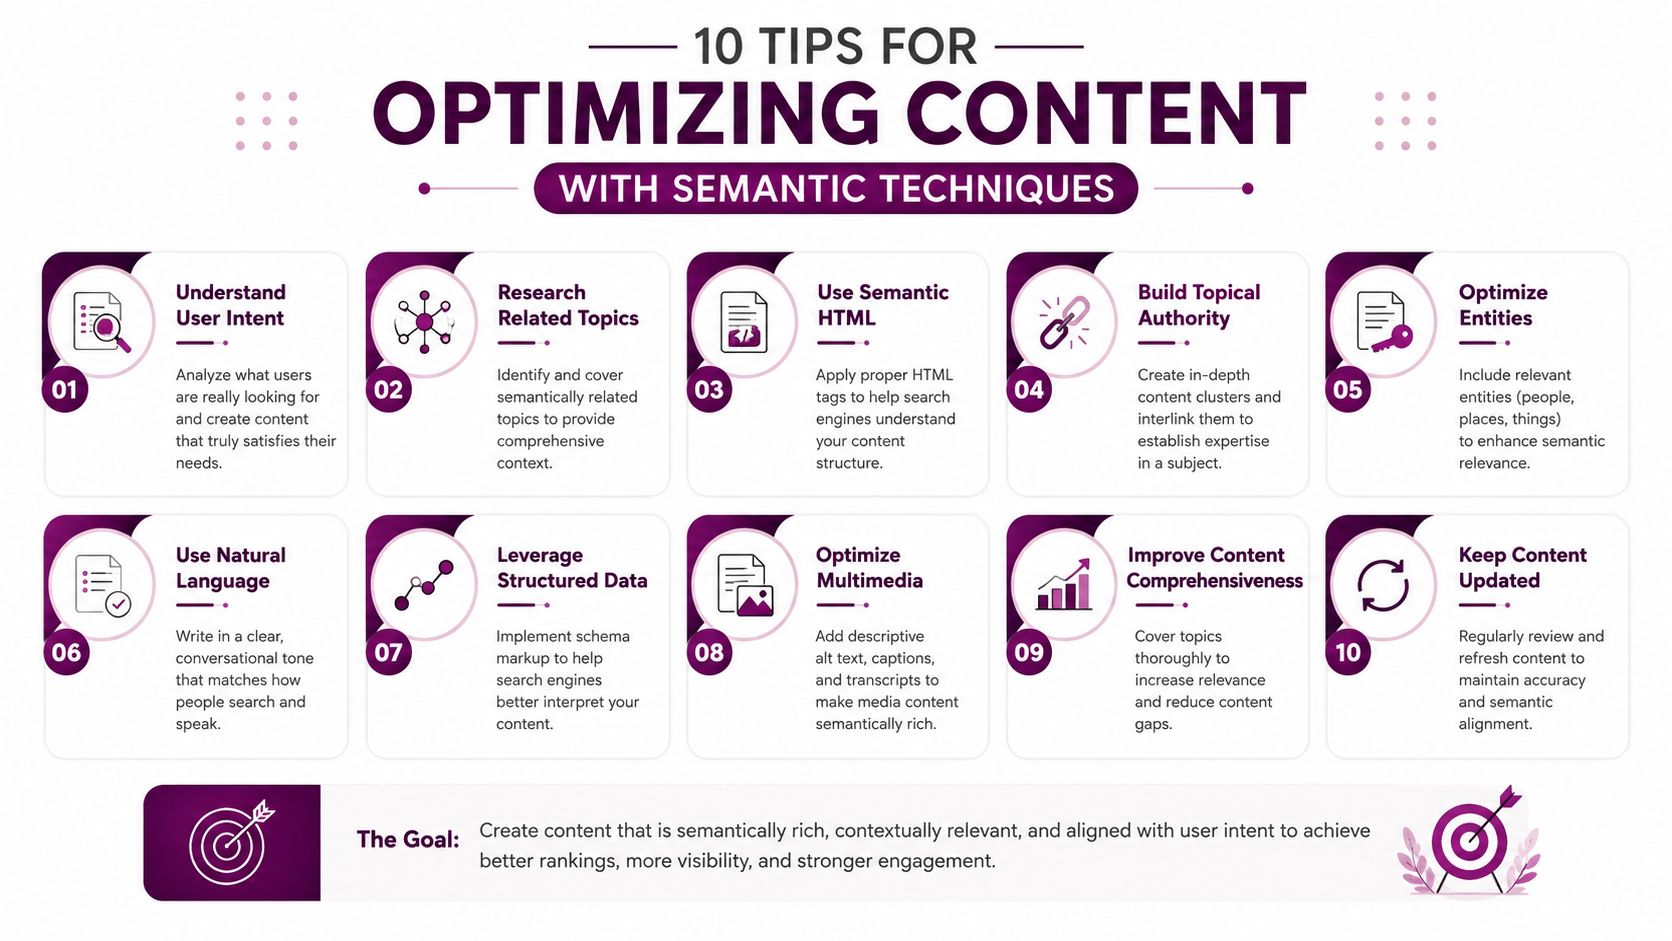
Beginnen Sie mit einer Seite, die eine Kernintention beantwortet, und ordnen Sie dann die verwandten Entitäten zu, die natürlicherweise dazugehören. Eine Produktseite über Laufschuhe sollte nicht nur den Begriff „Laufschuhe“ wiederholen, sondern auch Passform, Dämpfung, Laufstil, Untergrund und Anwendungsfall abdecken, wo relevant. Diese Art der semantischen Abdeckung signalisiert thematische Vollständigkeit, ohne erzwungen zu wirken.
Nützlicher Test: Wenn ein Begriff in einem Glossar neben dem Seitenthema seltsam aussehen würde, lassen Sie ihn weg.
Eine zweite Taktik ist die Nutzung von Überschriften als semantische Wegweiser. H2- und H3-Überschriften sollten die wichtigsten konzeptionellen Zweige des Themas widerspiegeln, nicht nur Keyword-Varianten. Das hilft Lesern beim Scannen der Seite und Suchsystemen beim Verständnis der internen Logik.
Vergleich statt Wiederholung nutzen
Die effektivsten semantischen Seiten lesen sich oft wie sorgfältige Vergleiche. Sie unterscheiden verwandte Ideen, klären Grenzfälle und beantworten die Fragen, die Leser als Nächstes stellen könnten. Das ist besser, als eine Phrase in leicht unterschiedlichen Formen zu wiederholen.
Ein einfacher Workflow funktioniert gut für bestehende Seiten:
- Lesen Sie die Seite als Neuling. Markieren Sie alle Abschnitte, die dieselbe Idee wiederholen, ohne Kontext hinzuzufügen.
- Prüfen Sie die Konkurrenzseiten. Notieren Sie, welche Unterthemen diese abdecken, die Ihrer Seite fehlen.
- Fügen Sie fehlende Entitäten natürlich hinzu. Verwenden Sie diese in Erklärungen, Beispielen und unterstützenden Abschnitten.
- Kürzen Sie Füllsprache. Halten Sie die Seite auf die Kernaufgabe oder -frage fokussiert.
- Überprüfen Sie die semantische Abdeckung nach der Bearbeitung. Ein semantisches Audit sollte zeigen, dass das Thema aus verschiedenen Blickwinkeln erklärt wird, nicht mit Synonymen aufgebläht ist.
Für Teams, die einen strukturierten Content-Workflow wünschen, ist dieser Leitfaden zur Content-Optimierung ein nützlicher Ausgangspunkt.
Balance zwischen Breite und Zurückhaltung
Grundlegende LSI-Forschung etablierte auch, dass Term-Dokument-Matrizen üblicherweise mit etwa 50–100 orthogonalen Faktoren approximiert werden. Das zeigt, dass es bei der Methode um die Balance zwischen Reduktion und Leistung geht, nicht um die Maximierung des Volumens Stanford Linguistik-Paper. Diese Idee lässt sich gut auf SEO-Texte übertragen: Breite Abdeckung hilft, aber nur, wenn jedes hinzugefügte Konzept seinen Platz verdient.
Wenn Sie eine einfache Regel suchen, nutzen Sie diese: Fügen Sie Konzepte hinzu, die die Antwort vertiefen, nicht Wörter, die sie lediglich dekorieren. Semantische Optimierung funktioniert, wenn die Seite einfacher zu klassifizieren und vertrauenswürdiger wird.
Fazit und nächste Schritte
Latent Semantic Indexing begann als Information-Retrieval-Methode, die auf SVD, verborgenen Ko-Vorkommensmustern und Low-Rank-Approximation basierte. Es ist keine Taktik für Synonym-Stuffing und kein magischer SEO-Hebel. Es ist ein nützliches Fundament, um zu verstehen, warum Bedeutung, Kontext und Themenstruktur bei der Suche so wichtig sind.
Diese Geschichte führt zu einer praktischen Schlussfolgerung: Moderne Suchmaschinen nutzen weitaus fortschrittlichere semantische Systeme, aber die Kernlektion bleibt unverändert: Seiten gewinnen, wenn sie ein Thema klar abdecken und dieses Thema mit verwandten Konzepten unterstützen, die für Menschen Sinn ergeben. Wenn Ihr Team „LSI-Keywords“ wie eine Formel behandelt hat, hören Sie damit auf und beginnen Sie stattdessen, Content auf semantische Vollständigkeit zu prüfen.
Wählen Sie eine Seite, die für Ihr Unternehmen wichtig ist, überprüfen Sie die thematische Abdeckung und straffen Sie die Struktur um die zugrunde liegende Intention der Suchanfrage. Messen Sie dann, ob die Seite besser lesbar ist, Fragen umfassender beantwortet und einen klareren Suchzweck unterstützt.
Ein CTA für Keyword Kick.